原文:huggingface.co · DeepSeek-AI, 2026
摘要: 长程agent的普及让模型负载越来越偏向输入侧。此前的工作已经大幅降低了长上下文的计算开销,但prefill仍然很贵,庞大的KV cache也持续挤占HBM、SSD的容量和传输带宽,这些计算、存储、带宽上的需求是进一步降低部署成本的主要瓶颈。本文提出DeepSeek-V4.1-Flash,一个552B骨干参数、支持1M上下文的多模态MoE模型。借助Causal Encoder-Decoder(CED)结构,模型decode时每token激活16B参数,prefill时只激活8B。为了把KV cache压到极限,模型结合了Compressed Sparse Attention 2(CSA2)里的跨层KV复用和FP4 KV cache,把常驻HBM的global KV压到每token 890字节,约为DeepSeek-V4-Flash的1/4;再通过部署侧的SWA Bounded Replay,把常驻SSD或host memory的persistent KV压到V4-Flash的约1/8。在KV cache小得多的情况下,模型效果明显好于基线。此外还精简了V4的结构,引入了几个高效的结构扩展。模型在45T token的多模态语料上预训练,并做了完整的后训练。
1. Intro
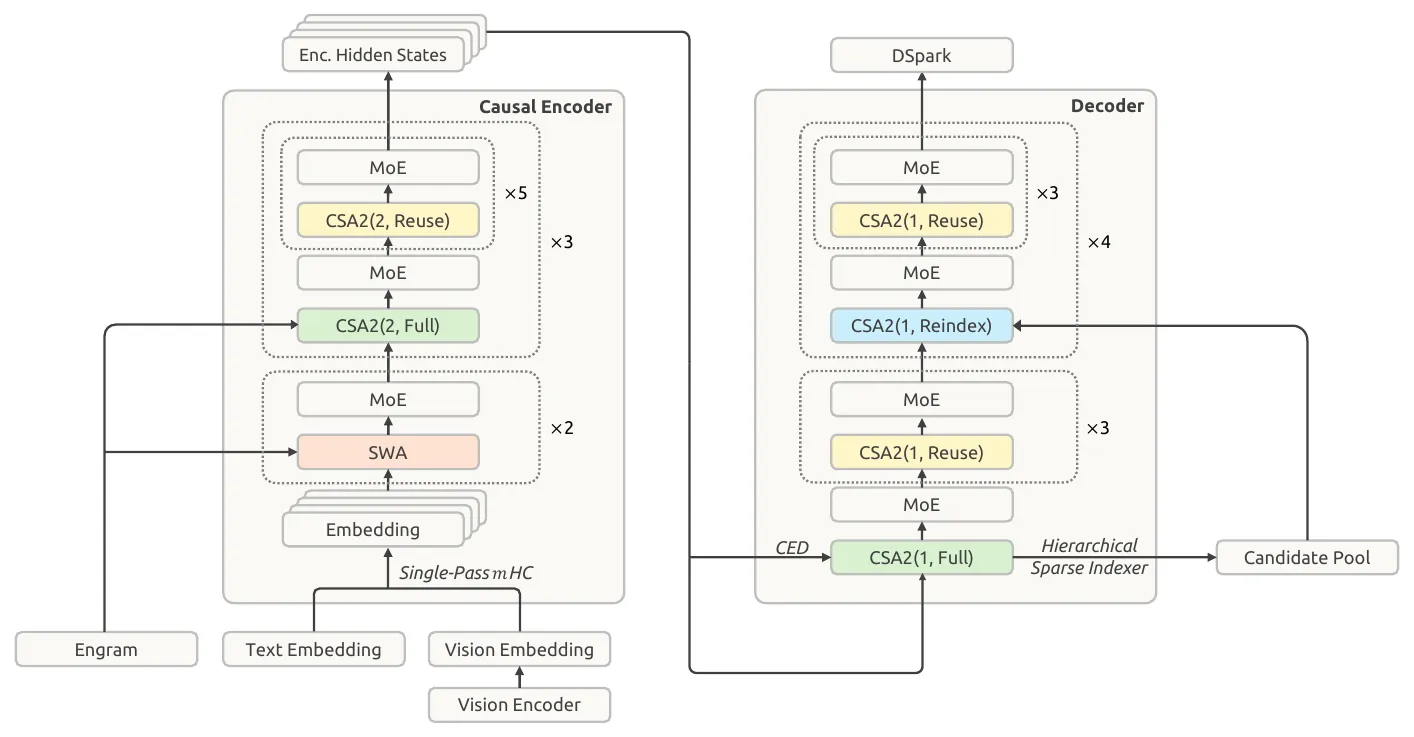
V4的attention可以看成两个分支:每层都有的SWA(窗口),加上一个看全上下文的global分支。global分支把历史压缩成main KV,再用一个轻量的indexer给每个query选Top-K条做稀疏attention,main KV和indexer K合起来就是报告里说的global KV。SWA的KV大小和序列长度无关,序列足够长的时候占HBM的主要是global KV。另外为了prefix复用还有一部分KV要持久化到SSD或者host memory里(persistent KV),这部分还受I/O和互联带宽的限制。
这样一个长上下文请求的开销基本就是四块:
- prefill的计算。agent每次tool call回来都是一段新输入,cache miss的部分要完整过一遍网络;
- 运行时常驻HBM的global KV,决定单卡能同时挂多少条长会话;
- 落在SSD/host memory上的persistent KV;
- decode时随上下文长度增长的部分,有了稀疏attention之后主要就是indexer的打分。
原文的出发点是把V4看成“SWA的局部主干 + 压缩过的全局上下文”,所以这一版基本只动global分支,SWA分支保持原样。后面的设计都能看到这个取向:CED只改global KV的来源,CSA2只共享global KV和Top-K,FP4也只用在main KV上。SWA KV还是每层用自己的hidden state算、每层单独存、保持FP8(原文说它对量化比较敏感)。
setup:
- 40层,d=5120,encoder 20层 + decoder 20层,最底下两层只有SWA
- 每层MoE:1 shared + 384 routed,top-6,expert中间维2304,SwiGLU带clamp(阈值10)
- attention:64个query head,head dim 512,query低秩维1280,KV latent 512维,output projection分8组、每组1024维
- indexer:32 head,head dim 128,attention top-k 512;层级索引最多选2048个block,每个block 8个位置
- mHC扩展因子n=4,Sinkhorn-Knopp迭代20次
- ViT:32层、1024维、16 head、patch 14、2D-RoPE,后接3×3 pixel-unshuffle和2层MLP projector
- 参数量:骨干552B + Engram 196B,prefill激活8B、decode激活16B。粗算一下骨干里大概545B都在expert里(40×385×3×5120×2304)
2. 890 bytes/token
作者把KV的开销拆成三个相乘的维度:entry本身的大小(GQA减KV head、MLA让所有head共享一个小latent都算这一类)、序列维(每个token压成一条entry)、层维(一部分层不存自己的KV,用别的层的)。写成式子是
entry大小:main KV是512通道的latent,存成E2M1,每16个通道带一个1字节的E4M3 scale,
折合每通道4.5bit。indexer K是128维的MXFP4,每32个元素一个E8M0 scale,64+4=68B。合起来一条entry是356B。
层的排布:
- encoder:2层纯SWA之后分3组,每组1个Full + 5个Reuse,压缩比;
- decoder:5组每组4层,第1组是1个Full + 3个Reuse,后面4组是1个Reindex + 3个Reuse,。
三种模式只有Full层会产生KV,所以(从0开始数):
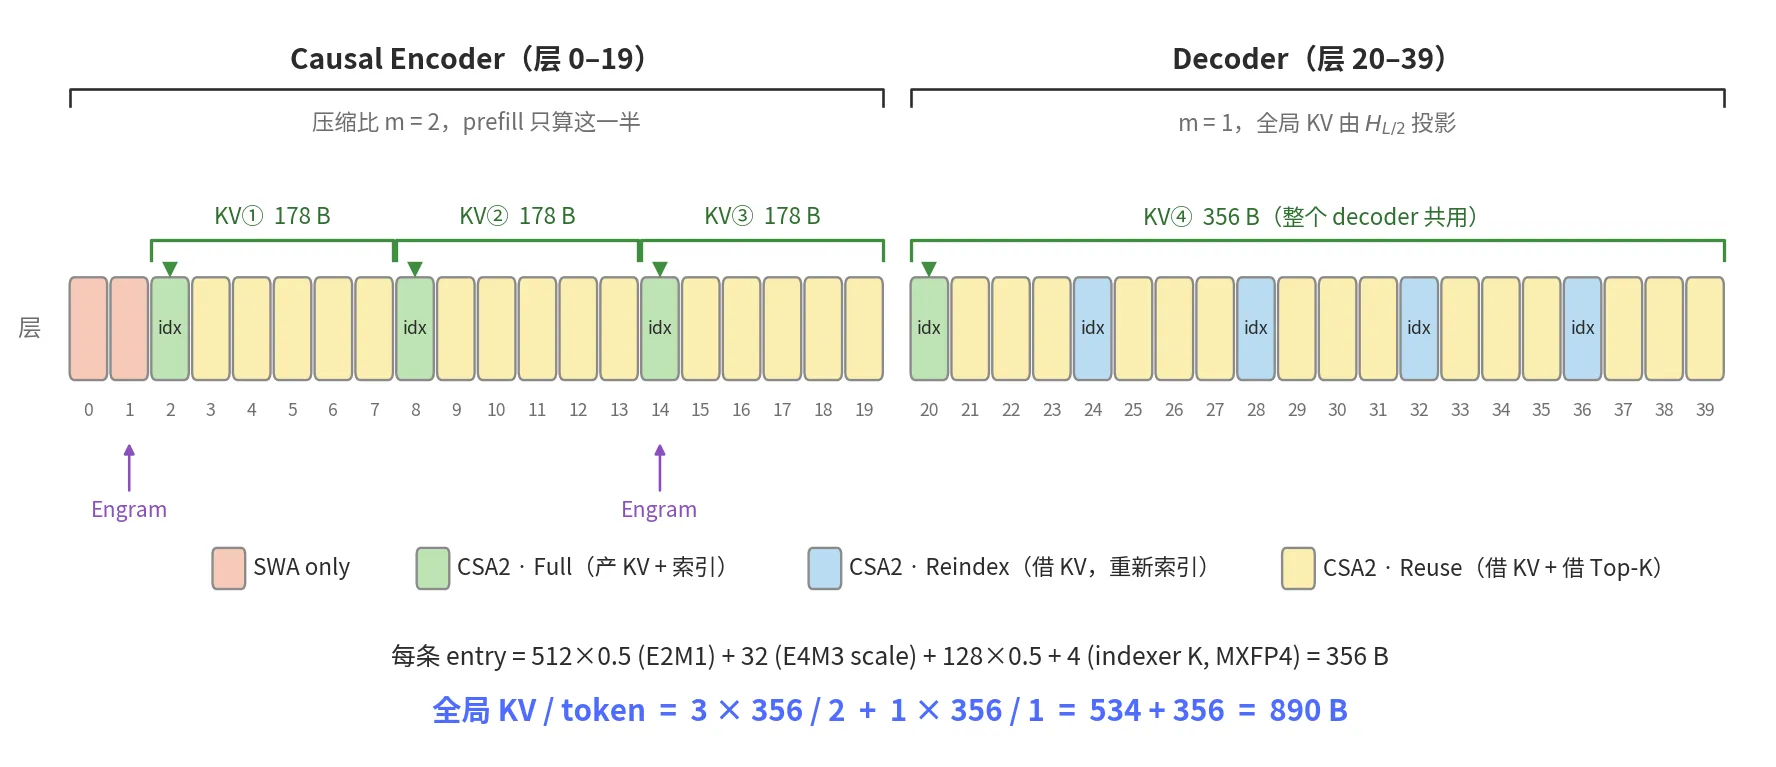
indexer K这部分(单head 128维、每32个元素一个scale)是我参考V3.2和V4的做法补的,报告里没有逐项列出来,不过最后的结果和890完全对上了。同样的算法也能对上报告Figure 1(b)里V1和V3.2的数字:
| 模型 | 算式 | B/token |
|---|---|---|
| DeepSeek-V1 (67B) | 95层 × 2(K和V)× 8个KV head × 128维 × 2B(BF16) | 389,120 |
| DeepSeek-V3.2 | 61层 × [(512B FP8 latent + 16B scale + 128B RoPE分量) + (128B indexer K + 4B scale)] | 48,068 |
| DeepSeek-V4-Flash | 报告给的数 | 3,514 |
| DeepSeek-V4.1-Flash | 见上 | 890 |
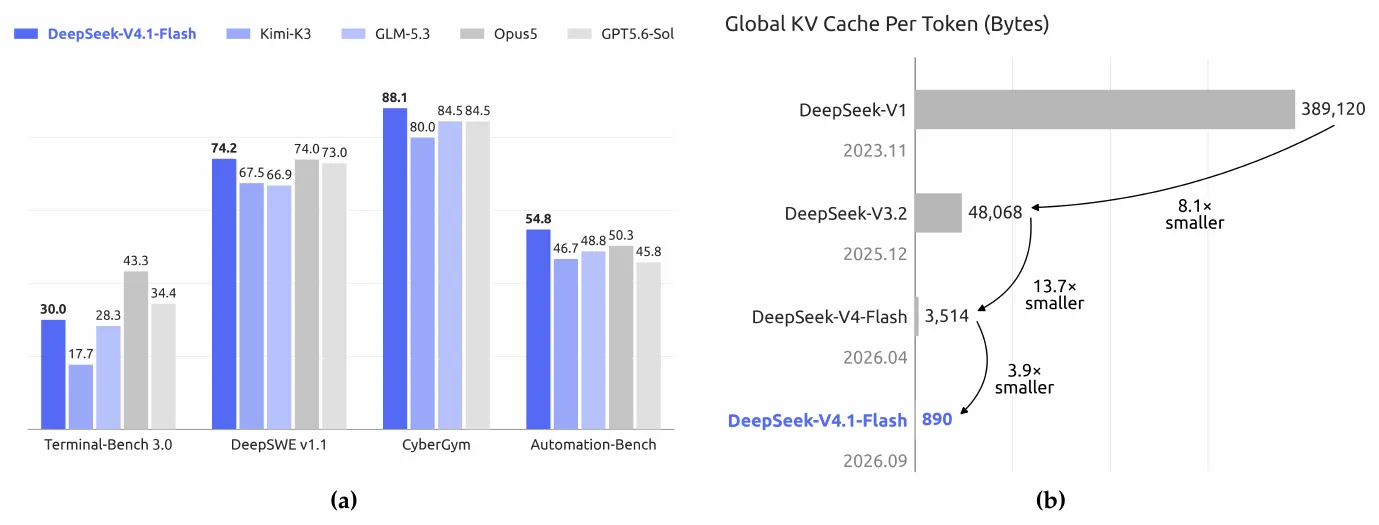
按这个数字,1M上下文的global KV只有890MB,V3.2同口径下是48GB。另外decoder这边,这份KV在序列维上完全没有压缩,890里面有356是它占的,可能的原因放在4.2讨论。
3. Causal Encoder-Decoder
3.1. CED
agent场景里频繁的tool call会带来大量prefill请求,cache miss的时候开销很大。CED受YOCO1启发,YOCO的做法是让上半部分的层直接共用下半部分产生的KV cache,这样prefill只用算下半部分。
CED把底下层当作causal encoder,上面层当作decoder。decoder各层的global KV(以及压缩用的权重)不再从本层的hidden state 来,统一从encoder最后一层的输出投影:
SWA分支不变,每层的local KV还是从本层的算。这两点放在一起,prefill和decode的数据流就不一样了:
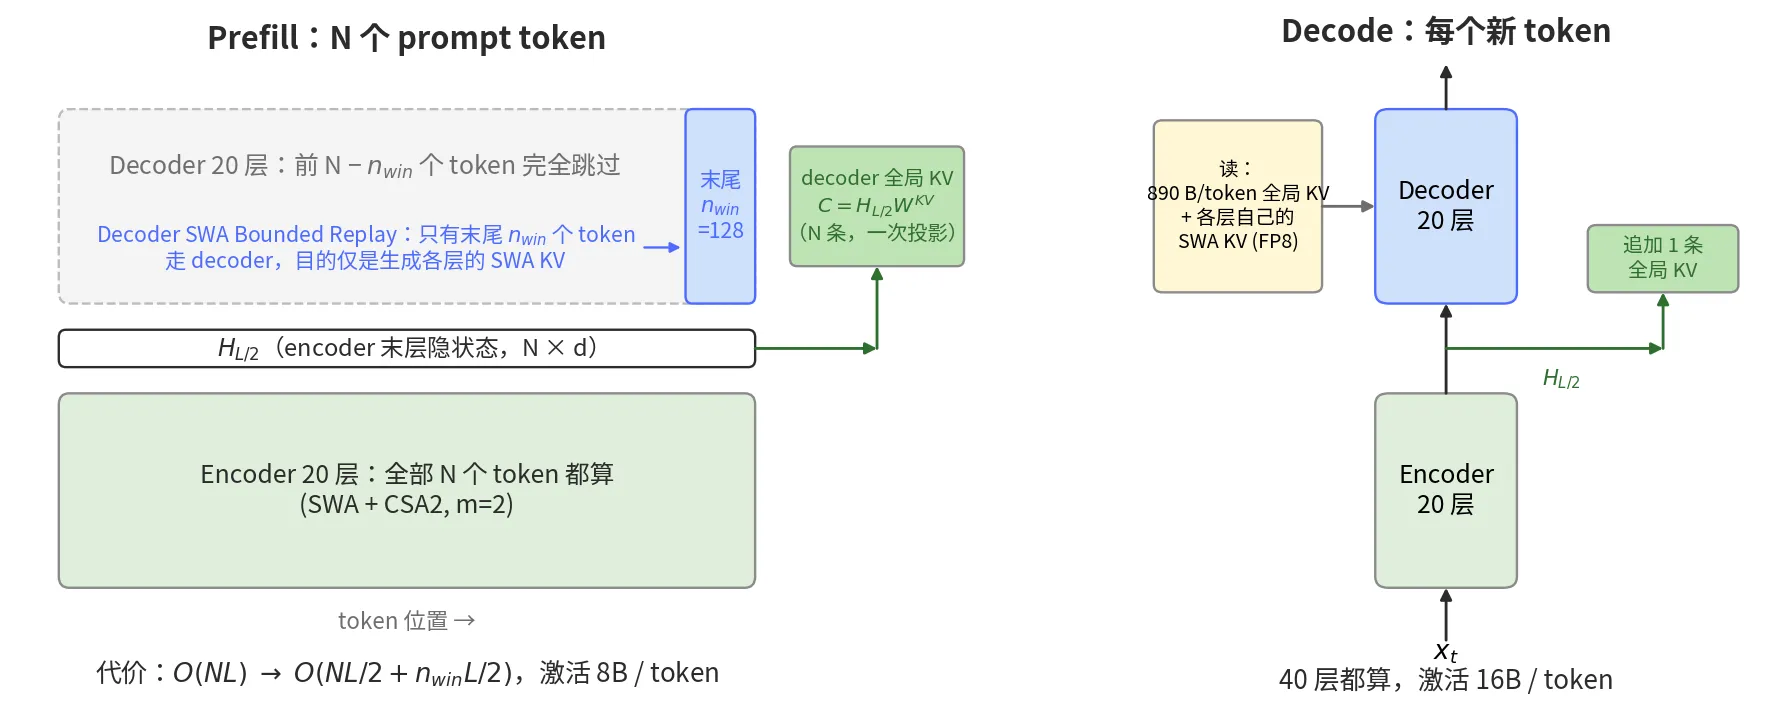
prefill的时候decoder需要的global KV只依赖,所以prompt里除了最后个token之外都不用进decoder;decode的时候每个新token要走完40层,同时把自己的投影成一条新的global KV。时prefill复杂度从变成,基本减半。所谓prefill激活8B、decode激活16B也是这么来的,参数是同一套,prompt token只过了一半的层。
3.2. CED vs. YOCO
报告里只说了“做了一系列结构上的改进来提升KV cache容量和KV生成的计算深度”,没有逐条展开。对照YOCO原文看下来,区别大概是三点:
- encoder自己也有global attention。YOCO的下半部分只用local/linear attention,全网只有一份global KV;CED的encoder里有3个Full层各存一份,加上decoder一份一共4份;
- decoder每层保留自己的SWA KV,local信息还是随深度逐层生成的,代价是decoder的SWA状态在prefill结束的时候需要补算(3.3);
- 式(1)里的投影是逐层的,不过和CSA2叠在一起之后,decoder里真正执行式(1)的只有第20层这一个Full层,剩下19层都复用它的结果。
3.3. Decoder SWA Bounded Replay
decoder的SWA KV是不进cache的,但decode的头几步又要用。精确重建的话需要让个decoder层跑最后个prompt token(SWA的依赖每过一层向前扩一个窗口),在“很长的cached prefix + 很短的新输入”这种多轮场景下,这部分比新输入本身还贵。作者引了PowerAttention2的结论,SWA实际的有效感受野远小于理论值,于是只重放最后个token,attention窗口在重放段的起点截断。作者称对效果的影响可以忽略,保险起见后训练的时候也模拟了同样的replay过程让模型适应。encoder那边还有一个同名的机制,放到第6节一起说。
4. Compressed Sparse Attention 2
4.1. 单层的计算
单层的计算:
其中block不重叠、indexer K从main KV投影、top-k取512、窗口128是报告里明确写的;序列压缩用softmax加权、打分用多head的ReLU加权和,这两个具体形式是沿用DSA/V4的写法,本文没有重写,算是我补的。
相对V4的CSA,单层内有三处简化:
- V4里压缩比为时每条entry由个原始entry产生,相邻entry的来源有重叠,还要加绝对位置编码来区分这个位置,CSA2把重叠和绝对位置编码都去掉了;
- V4的indexer K走一条从hidden state出发的独立压缩路径,CSA2直接从main KV投影;
- V4是CSA和HCA(Heavily Compressed Attention)混用,V4.1只用CSA2,就是不压缩的特例。
4.2. Full, Reindex, Reuse
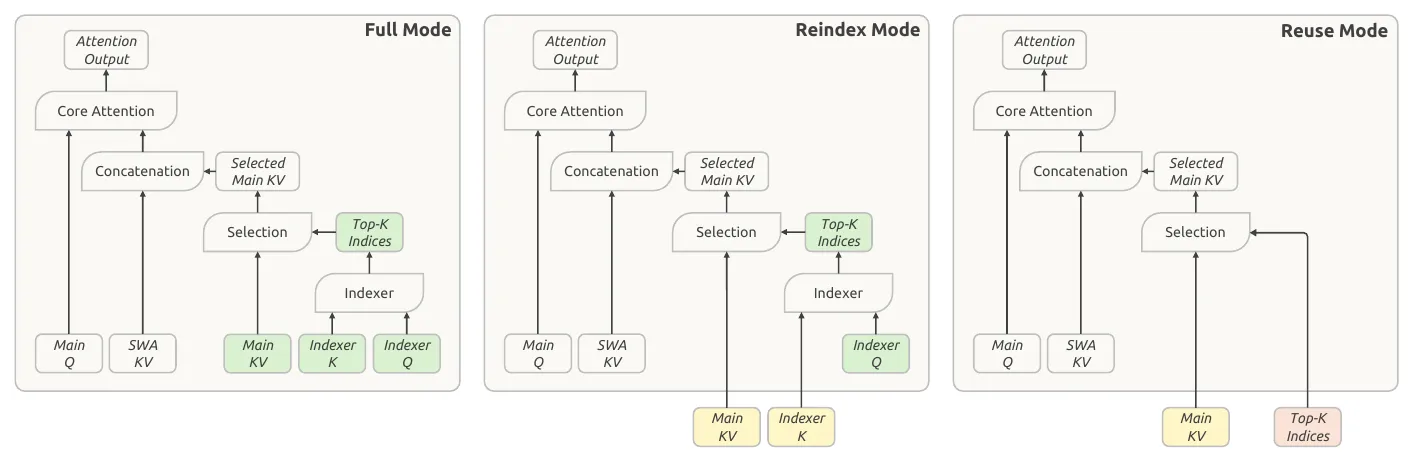
每个CSA2层静态地被指定为三种模式之一。三种模式都自己算main Q和SWA KV,区别在main KV、indexer K和Top-K indices从哪来。记为第层之前最近的Full层,为最近的Full或Reindex层:
| 模式 | main KV、indexer K | Top-K indices | 新增KV存储 | indexer计算 |
|---|---|---|---|---|
| Full | 本层产生 | 本层打分 | 有 | 有 |
| Reindex | 无 | 有 | ||
| Reuse | 同上 | 无 | 无 |
相关工作方面,作者的定位是:IndexCache3跨层复用Top-K但不省main KV;YOIO4全网只算一次sparse routing,性能受限;HySparse5让稀疏层复用dense层的KV,但还保留了完整的full attention层;CLA6是更早的跨层共享KV的工作。CSA2相当于把“共享cache”和“复用index”解耦,三个维度一起用。
38个CSA2层里4个Full、4个Reindex、30个Reuse,真正产生KV的只有4层,跑indexer的只有8层。占绝大多数的Reuse层推理时每层只有15个kernel(prefill)/ 11个kernel(decode)。
encoder是“3份KV + 3次index”,decoder是“1份KV + 5次index”,报告没有解释为什么这么排。我的猜测是encoder的hidden state随深度在变,第2、8、14层各自重新产生KV能拿到不同层次的表示,每份178B/token存下来是划算的;decoder受式(1)的限制,任何一层的global KV都只能投影同一个,多存几份也只是同一份信息的不同线性变换,意义不大。但decoder各层的query还是随深度变化的,让Reindex层用新的query在同一份KV上重新选一遍就比较划算。decoder取大概也是这个原因,整个上半网络的全局信息都压在这一份KV上,再压序列维损失就比较大了。
4.3. Hierarchical Sparse Indexer
跨层复用减少了indexer跑的次数,但每次还是要扫整个可见上下文,上下文特别长的时候这仍然是主要的计算瓶颈。作者发现在decoder里,浅层indexer的结果可以直接拿来限制深层indexer的搜索范围,不需要引入额外的状态。
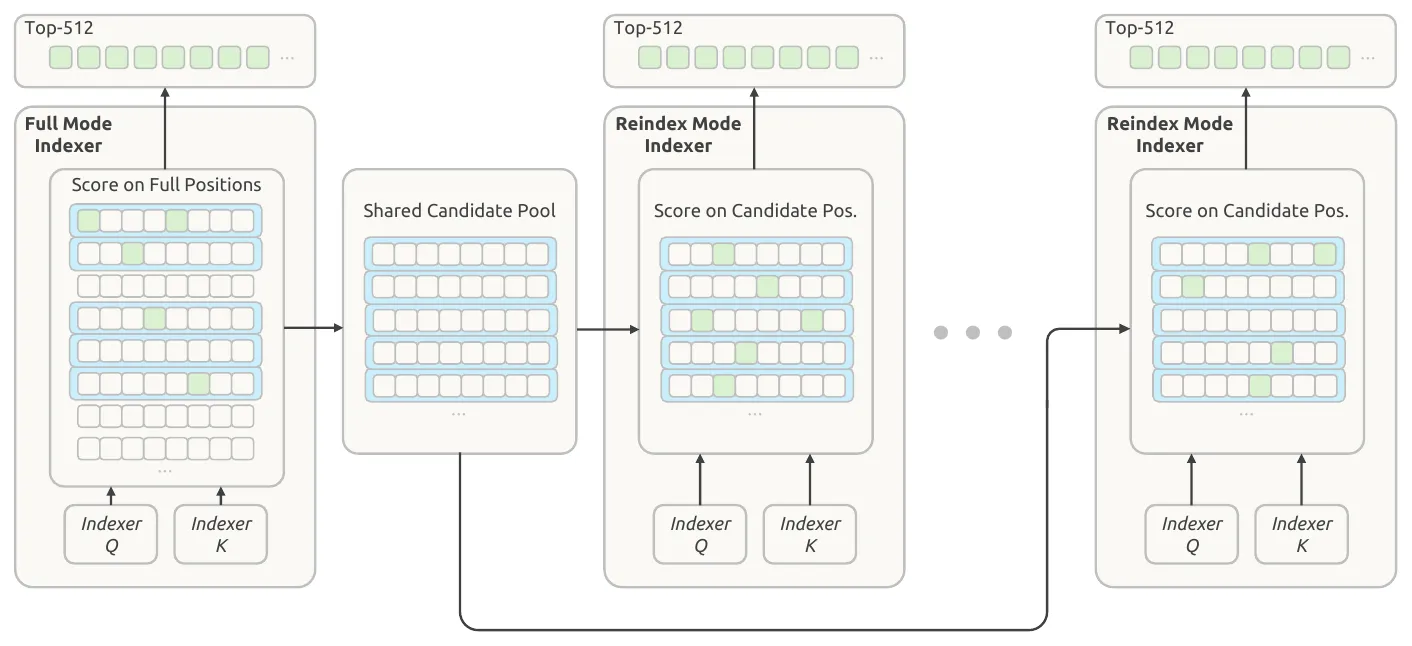
decoder的第一个Full层照常对全部可见位置打分、选出自己的Top-512,同时按block取最大分数,选出分数最高的一批block组成candidate pool,后面的Reindex层只在pool里打分:
candidate pool是各个Reindex层共用的,每层在pool里最后选出来的Top-512可以不一样。这个机制只用在decoder上,并且是后训练阶段才加进去的,训练和推理用同样的候选限制。
4.4. Decode FLOPs
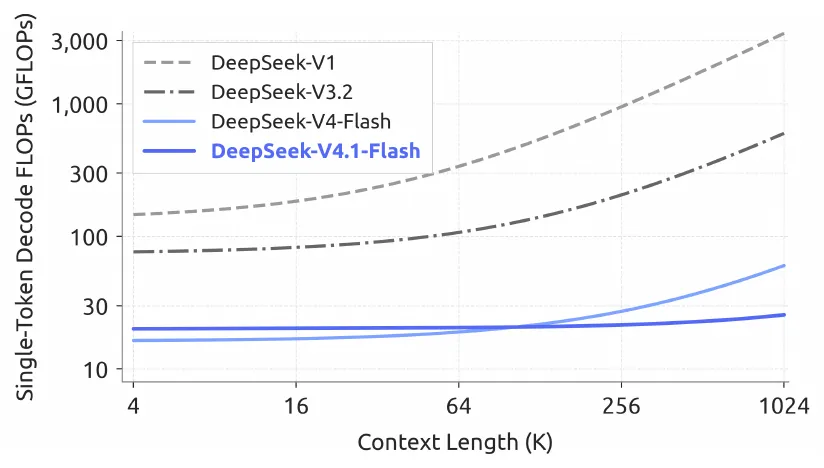
报告Figure 2里,上下文从4K到1M(256×),单token的decode FLOPs只涨了大约1/4(BF16、FP8、FP4分别按1、0.5、0.25加权)。这个1/4也可以估出来。decode时每个新token要过全部40层,4个Full层的indexer要对所有可见entry打分,4个Reindex层只对16,384个候选打分,每对(query, entry)的打分是32×128=4096次乘加:
=1M的时候是10.2G次乘加,折合20.5 GFLOPs,按FP4的0.25加权之后大约5.1 GFLOPs,和图上从20左右涨到25左右基本吻合。顺着这个估算还能看到几件事:
- 线性项的系数同样来自3/2+1=2.5个“等效全量层”,和890的来源是同一个;
- 如果没有Hierarchical Indexer,4个Reindex层也要扫全量,系数从10,240变成26,624,1M处的增量会是13 GFLOPs左右;
- 上下文在100K以内的时候,图上V4.1-Flash的decode FLOPs其实比V4-Flash还高(约20 vs. 约17 GFLOPs,激活16B vs. 13B),短上下文decode这块V4.1是没有优势的;
- encoder在prefill时的indexer还是的:3个Full层、个query、平均条entry,大约次乘加。同样的加权口径下(粗略假设主干计算全按FP8算),1M时大概占prefill主干计算的15%~20%,256K时5%左右。这个数只能看个量级,Hierarchical Indexer没有覆盖到这一块。
5. FP4 Main KV Cache
V4已经对indexer的Q/K做了FP4的QAT,用的是OCP标准的MXFP4。作者的解释是indexer的FP4要直接参与矩阵乘,得照顾尽可能多的硬件,所以即使实验里别的格式精度更高也还是选了标准格式。V4.1把QAT扩展到main KV,这里FP4只是为了省存储,cache在进attention之前先反量化,所以可以挑精度更高的格式,不要求硬件原生支持这个格式的矩阵乘。
最后选的是E2M1 + 每16通道一个E4M3 scale,和NVFP4一样,只是去掉了第二级的global scale。对一个16通道的块:
能表示的最大幅值是448×6=2688。去掉global scale的依据是一个范围估计:训练完RMSNorm weight的最大幅值大约是1,512维latent过完norm之后;RoPE是旋转不改范数,旋转之后单通道幅值也不超过22.6;训练中实际观察到的最大值在10左右,离2688差两个数量级。
其他细节:QAT是后训练阶段才加的;RoPE和非RoPE分量用同一种格式;量化放在RoPE之后(放在之前只有很小的精度收益,但decode会多出开销);SWA KV保持FP8。相比V4的FP8 main KV,存储接近减半。
有一处前后说法不太一致:摘要和intro里说训练时使用FP4 global KV cache,2.4.4里写的是main KV的QAT在后训练才引入,按后者的话45T的预训练期间main KV并不是FP4。
6. Persistent KV Cache & SWA Bounded Replay
V4线上用LRU管理SSD上的persistent KV cache,容量配到典型负载下两类KV都能留存72小时以上。其中SWA KV只在prompt末尾和输出末尾两个位置存快照(用于regenerate和多轮续聊),即便如此,未压缩的SWA KV还是占了persistent cache接近一半的容量,多轮短对话的时候更严重。
问题在于两类KV的复用模式完全不同:global KV是长尾复用,几小时几天之后还会命中;SWA KV只在活跃session内分钟级的窗口里被复用,session结束或者下一轮开始之后就是死数据了。用留存72小时的SSD去存寿命只有几分钟的数据显然不划算。V4的报告里提过Zero SWA Caching(不存,丢了就重算),但精确重算需要replay 个token,线上证明太贵了。
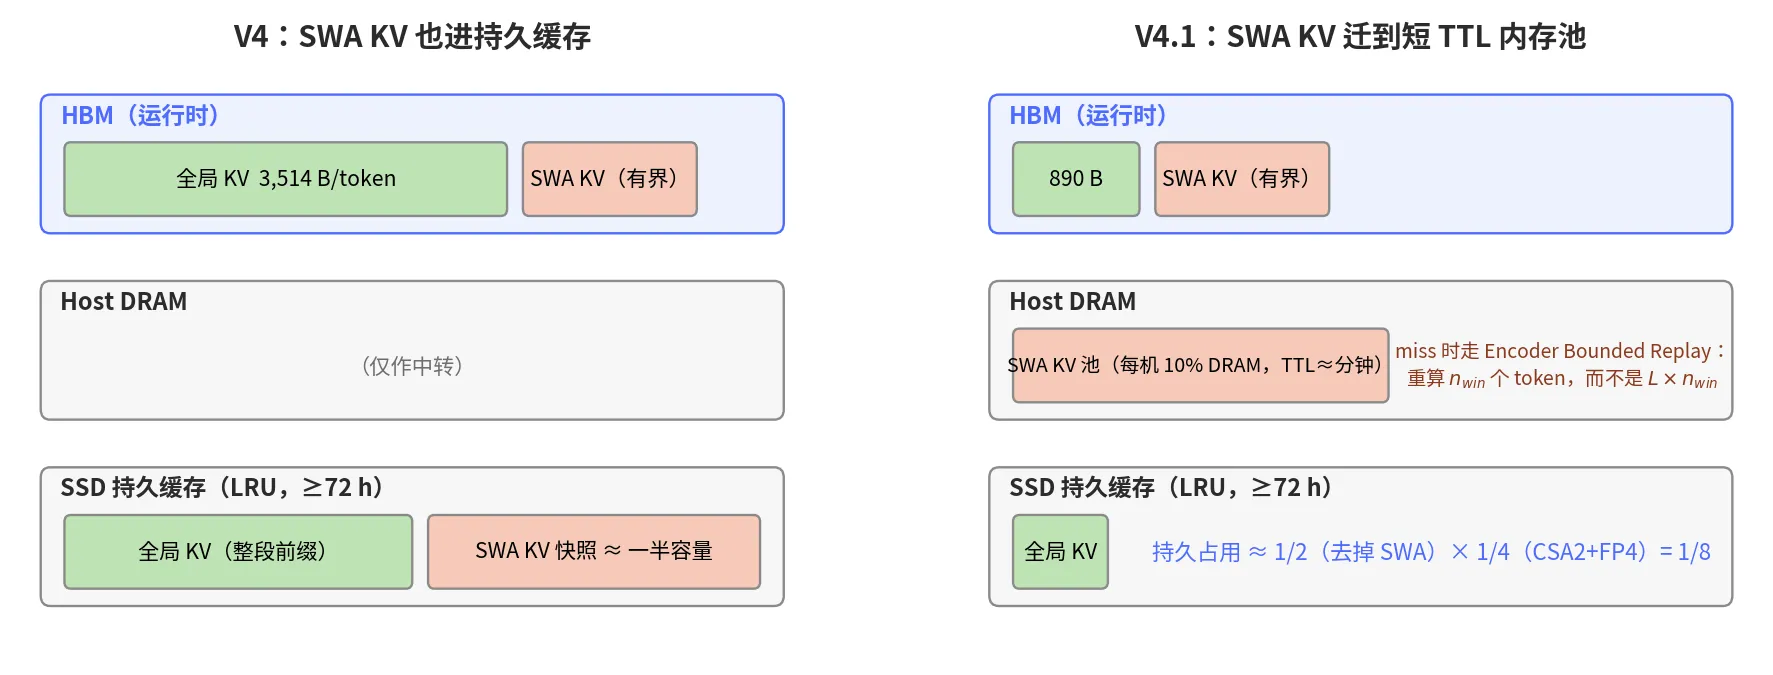
V4.1的做法是把SWA KV从persistent cache里拿出来,放进一个由每台机器10%的host DRAM组成的分布式内存池,TTL只有几分钟。池子总容量虽然小,但周转很快,作者说真实负载下足够服务绝大多数并发的活跃session。global KV还留在persistent cache里,保证至少72小时。这样persistent KV就是1/2(不存SWA)× 1/4(CSA2 + FP4)= 1/8。
SWA KV被淘汰之后必然会出现“global KV命中但SWA KV miss”的请求,这时候靠Bounded Replay来补:
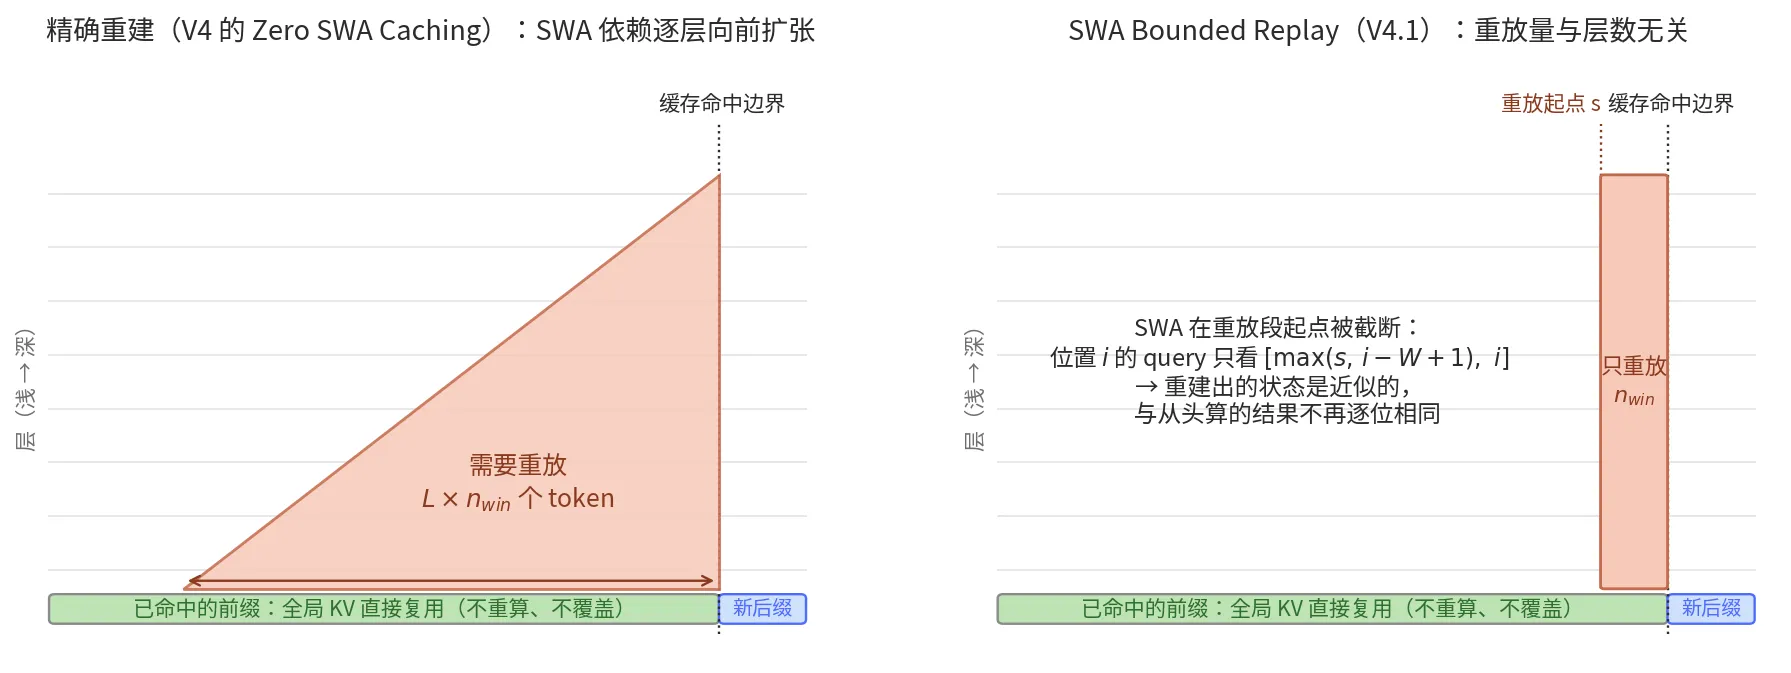
SWA的依赖每过一层向前扩一个窗口,精确重建层需要replay 个token。Bounded Replay只replay最近的个,并且把SWA截断在replay段内,从位置开始replay的话,位置的query只看。有两个变体:
- Encoder SWA Bounded Replay:replay cached prefix的最后个token,和没cache的后缀一起处理。replay的token只重新生成SWA KV,global KV直接复用、不重算也不覆盖,于是prefix caching只依赖global KV;
- Decoder SWA Bounded Replay:每次prefill都做(3.3),产生的decoder SWA KV只给后面的decode用,不进prefix cache。
作者也说明了这样做的后果:replay出来的prefix状态是近似的,所以后缀算出来的global KV和SWA KV依赖于cache命中的位置,不同命中位置下在数学上并不相同。换到使用者的角度,同一个prompt同一组采样参数,服务端有没有走replay会让logits有细微差别,做评测复现或者logprob对比的时候需要留意。作者在limitation里也把“cache恢复边界上的SWA状态重建”列成了需要继续压测的两个点之一,另一个是CSA2在长上下文上的选择误差。
7. Efficient Architectural Extensions
7.1. Single-Pass mHC
mHC7在相邻block之间维护条residual stream :
其中把条stream混成block的输入,和负责更新stream,三者都是逐token预测出来的系数。
从访存上看,两个block之间理想的变换是一个映射,读、写,下界是。而V4的实现是三个因为数据依赖必须串行的kernel:
加上里的pre-norm,总访存是,是下界的两倍(intro里说的“原来的四kernel实现”就是这三个加pre-norm)。
优化分两步。第一步不改数学:把里norm的weight离线折进projection weight,RMS的除法挪到projection之后,这样residual update和系数预测就能共用一次遍历,的每个tile算出来之后立刻累加进projection的输出和平方和。但input mixing融不进来,因为要等所有tile reduce完才有,只能再读一遍,这时候总访存是。
第二步改了数学,让每个block用上一个block产生的mixing系数:
这样依赖就没有了,的每个tile可以同时拿去做input mixing(用现成的)和系数预测的累加。部署用的Mega-mHC kernel把residual update、input mixing、系数预测、pre-norm和FP8转换全融在一起,residual只读一次写一次,达到的下界。
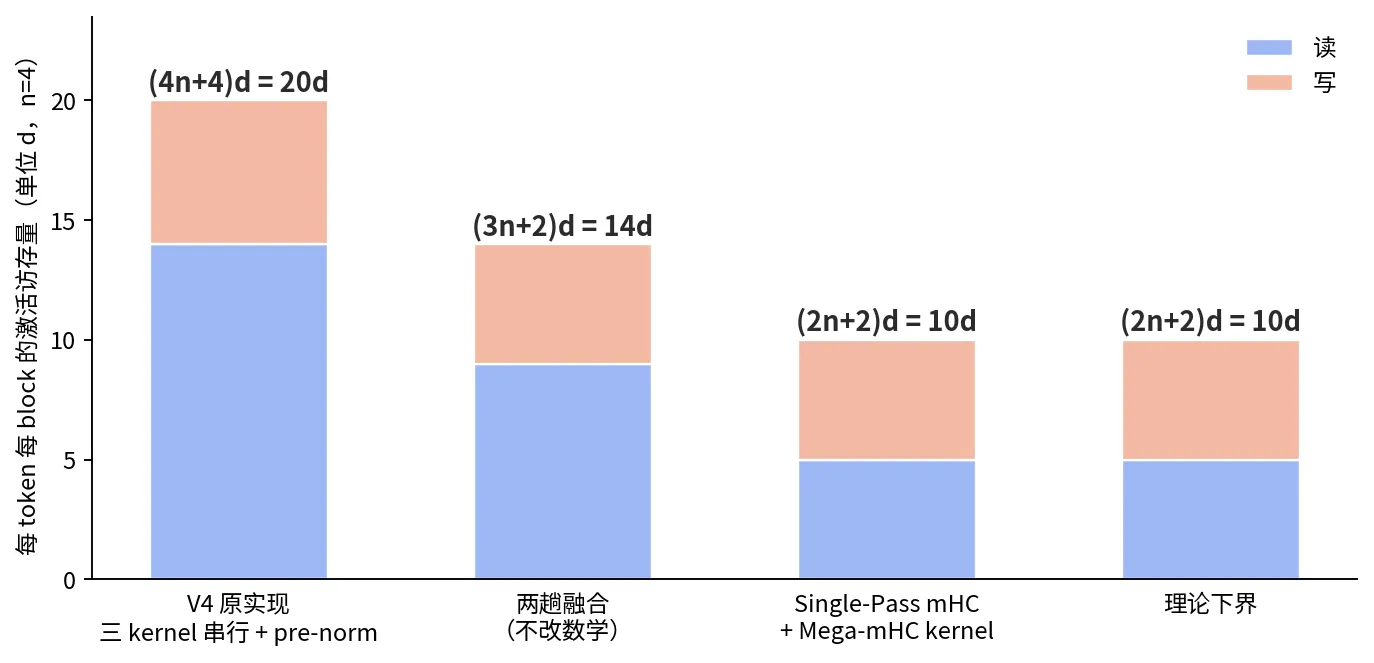
预训练还是用原来的多kernel实现(错位只改变用哪一份系数,不影响实现),作者称错位带来的性能损失可以忽略。第0个block用什么当报告里没有说。
7.2. Engram
Engram8是之前提出的conditional memory模块,用查表的方式加参数容量。V4.1沿用原来的设计(tokenizer compression、multi-head hashing、context-aware gating、multi-branch integration),改了两处:去掉了short causal conv,理由是收益抵不上推理栈里多一个算子的复杂度;embedding table改用Sinkhorn-balanced update来优化(第8节)。
配置上是两个module,放在第1层和第14层(从0开始数,这么放是为了均衡各个PP stage的内存)。每个module用2/3/4-gram,每阶8个hash head、embedding总维度2048,每个head对应一张约16M行的表,表长取互不相同的质数,表和K/V projection都是FP8。参数量可以对一下:2×3×8×16M×(2048/8)≈196.6B。
按原论文的结构,计算过程大致是下面这样(记号是自己整理的,gating的具体形式是凭印象写的,可能和原文有出入):
寻址是确定性的,只依赖输入的token序列,系统实现上基本都在利用这一点。推理时表放在host memory里,通过后台RDMA预取,第一个module的预取和第一个Transformer block的计算overlap。训练时表按行切到专门的engram parallel进程组,整个local batch的预取在pipeline开始处理microbatch之前就发起,梯度回传和ViT的backward overlap。RL rollout的时候表常驻GPU显存,避免host memory碎片导致OOM。
报告里没有去掉Engram的对照,能参考的只有base评测里的SimpleQA-Verified:V4.1-Flash 42.3,V4-Flash(284B)30.1,V4-Pro(1.6T)55.2。
7.3. DSpark
DSpark9是speculative decoding模块。V4.1的骨干预训练不再带MTP(报告里对比的是V3的做法,MTP在预训练里和骨干一起训)。drafter是3个Transformer block(滑窗128),一次forward并行给出5个draft位置的base logits,再用一个轻量的Markov head建模draft token之间的依赖;另外有一个confidence head预测每个位置的条件接受概率,scheduler结合这些概率和离线profile出来的引擎吞吐曲线,给每个请求动态选verify长度。
报告里只有文字描述,这里按自己的理解把scheduler的目标形式化一下,细节应该以DSpark原文为准。设是请求的第个draft在前面都被接受的条件下被接受的概率,prefix存活概率,verify长度取时期望产出个token,scheduler求解
是当前负载下单步时延关于batch内token数的实测曲线。系统空闲的时候多verify几个draft几乎没有成本,负载高的时候每多verify一个token都在挤别的请求的吞吐。
训练上,预训练结束之后单独开一个阶段,冻结骨干只训DSpark;后训练期间DSpark跟着骨干一起训,但DSpark目标的梯度不回传骨干。这样DSpark能一直跟上policy的变化,线上服务和RL/OPD的rollout都用它加速。
8. Optimization
第一处改动是head-wise Muon,把Query和Key的weight按head切开再分别做Muon update。作者的解释是把Muon看成preconditioned GD的话,原版对所有head共用一个preconditioner,按head切开之后每个head一个,更能适应head之间的异质性,并且提到GLM-5和Kimi-K3也验证了这一点。
第二处是针对Engram的。196B的新增参数如果用Adam,optimizer state要多两份。作者对Engram table、token embedding和LM head统一换成了momentum + Sinkhorn balancing,流程和Muon一样,只是把Newton-Schulz正交化换成了行列交替归一化,只需要一个momentum buffer:
收敛的时候相当于找到对角阵、,让的行RMS和列RMS都约等于1(报告式7)。超参:(取奇数让最后一步落在行归一化上)、、(对齐Adam的update幅度,和Moonlight用的0.2接近)、不加weight decay、Engram的lr乘5。
关于为什么这种update适合embedding类的矩阵报告里没有展开,我的理解是这类矩阵一行对应一个token或者一个n-gram,一列对应一个feature,各行梯度出现的频率差别很大。行归一化让当前step出现过的token不管频率高低都走一个单位RMS的步长,效果上接近Adam的逐行自适应,但不需要二阶矩的状态;列归一化再把各个feature维的update幅度拉平;把梯度接近0的行置零是为了防止没出现的token的噪声被放大成单位步长。作者提到这和Adafactor、Adam-mini这类利用矩阵轴结构的方法比较接近,系统的比较留给future work。
9. Pre-training & Infra
预训练配方(报告4.2.2):45T多模态token,作者称全程没有出现不稳定。batch固定100.6M token(1536×65,536)。lr先2000步linear warmup到2.6e-4,保持到28T,28T到40T之间cosine降到2.6e-5,然后保持到45T。稀疏attention从头开始在64K序列上训,没有dense warmup阶段(V3.2是先dense再转sparse),34T处把序列扩到1M。文本和多模态token的比例是7:1。
DeepSeek-ViT是单独训的,分两个阶段。先用SigLIP的sigmoid contrastive loss在约47B图文对上训,分辨率压在224×224,作者说这个阶段提分辨率虽然有局部收益,但对最终模型帮助很小;然后接一个4B的MoE LLM用NTP训236B token,分辨率544×544到1344×1344,训完丢掉LLM只留encoder。1344×1344的图是个patch,过完3×3 pixel-unshuffle是1024个视觉token。接入主干之后ViT一直冻结(只有最后一层norm和projector可训),到lr开始decay的时候才解冻,用更小的lr和LLM联合优化。
MoE的aux-loss-free load balancing给图像token和文本token各维护一套bias,routing的时候按token的模态取对应的bias选expert,加权还是用原始的routing score,两套bias各自按本模态的expert负载更新。
CSA2在PP下训练需要额外处理,因为共享KV/index的层可能落在不同的PP stage上。作者用了三个机制:
- shadow indexer:每个参与的stage上放一个可执行的副本,逻辑上仍然只有一个owner负责优化和checkpoint;
- pipeline payload extension:把下游需要的中间表示和sparse routing信息塞进现有的P2P通信,按CP一致地切分;
- micro-batch级的shared-state管理:跟踪在途micro-batch的共享状态,在forward、recompute、backward之间管理生命周期,最后一个consumer用完就释放。
另外长序列的图像加载也是个问题,一条超长、图像密集的序列会把单机的I/O和内存打爆,所以每条序列的图像被均衡地切到各个CP rank上,每张图只读一次。加载能被计算掩盖的条件是
其中是每token的原始字节数,是每token的计算量。被约掉了,判据和序列长度、集群规模都无关,作者据此认为存储吞吐只会在小模型ablation的时候成为瓶颈。
10. Post-training
作者明确说后训练没有算法上的创新,流程就是SFT -> RL -> OPD(on-policy distillation),实质的变化全在数据pipeline上。
10.1. Controllable Reasoning Effort
system prompt前面加一行Reasoning Effort: {b},取1到100。对每个prompt ,在每个训练用的档位上各采条response,只有相同的response构成一个subgroup,组内减均值算advantage,不同档位的response不直接比较。档位之间的行为差异完全由length penalty带出来:
是reasoning token数,是训练档位的平均间距。
选指数形式的理由在附录C。设题目在思考个token之后被解出的概率是,模型偏好的长度满足一阶条件;再假设边际收益近似指数衰减,,代入得到
在这个假设下偏好长度对档位是仿射的,斜率跟着题目的变。控制整体压长度的力度,控制档位之间的区分度。作者也说了这只是reward层面的局部近似,不保证实测的平均长度是线性的。
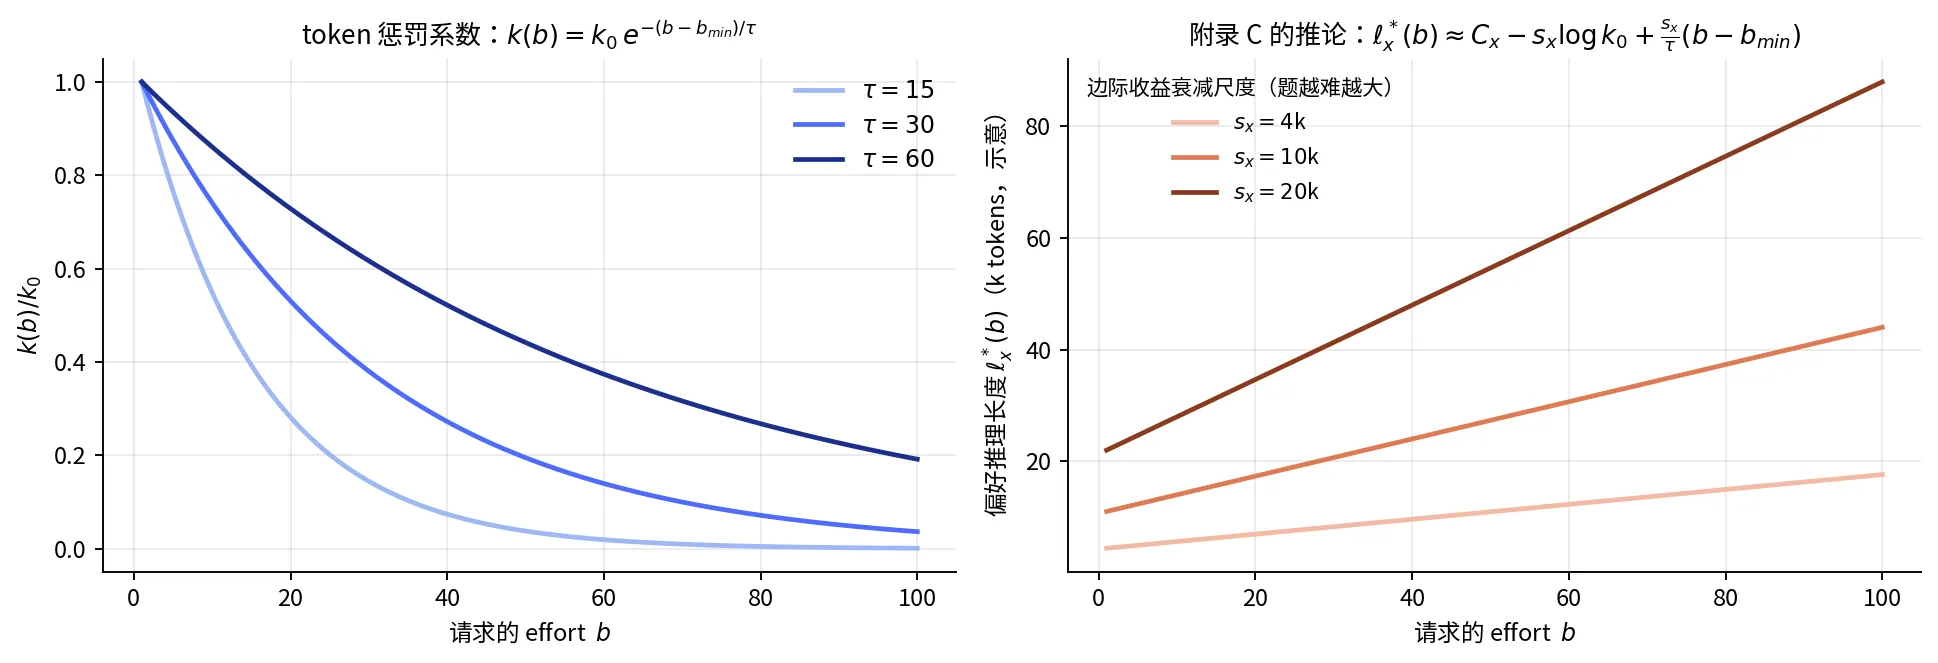
(上图只是示意,、、的实际取值报告没有给。)线上API的low/high/max三档对应=50/75/100,训练只用了有限个档位,中间值靠插值。
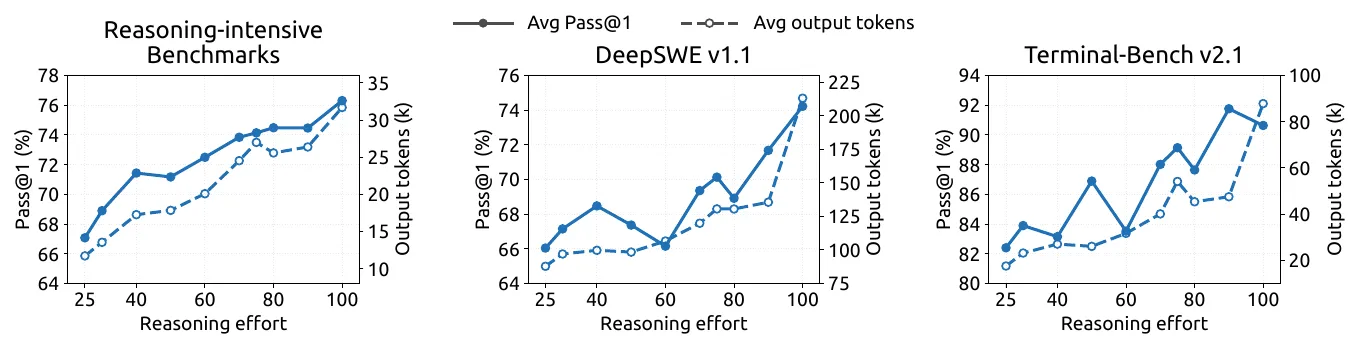
正文里说准确率随effort稳步上升,但图上DeepSWE和Terminal-Bench两幅其实并不单调,50到60附近有下降,80处也有回落,附录B.2自己写的也是Pass@1和effort只是松散相关,单调增长的是输出长度。按图读数,DeepSWE在=50时大约67.4,比=40的68.5左右还低;Terminal-Bench 2.1在=90时大约91.8,比=100的90.6高。按Table 4的注,这两个benchmark每题分别只采8次和3次,这些起伏可能就是采样噪声。另一个结论从图上看是成立的:60到80的档位已经拿到了大部分收益,最高档让agent轨迹变长1.6到1.8倍,提升很小。
10.2. Agent Task Synthesis & RL Infra
task synthesis:每个task表示成(problem, environment, verification system)三元组,质量从difficulty和correctness两方面衡量,作者用这两项当reward,迭代地训模型去构造更好的task;task每次被用于RL,产生的轨迹又拿来复查task质量。coding类的环境由多个agent分工构建:判断项目能不能在容器里build和自动验证,选起点commit、设计fail-to-pass和pass-to-pass的检查点,在隔离容器里搭环境并清掉可能泄露答案的痕迹,多个agent试做,再由独立的质检agent审查,不过的话修复之后重新验证。
RL的scaling沿两个方向:训练算力,以及scaffold的种类(多个版本的Claude Code、OpenCode、Pi、DeepSeek Harness)。多次RL run之间用model merging做重新初始化,把不同scaffold或配置下的checkpoint合起来,Figure 7里断开的曲线段对应的就是每一次重新初始化。
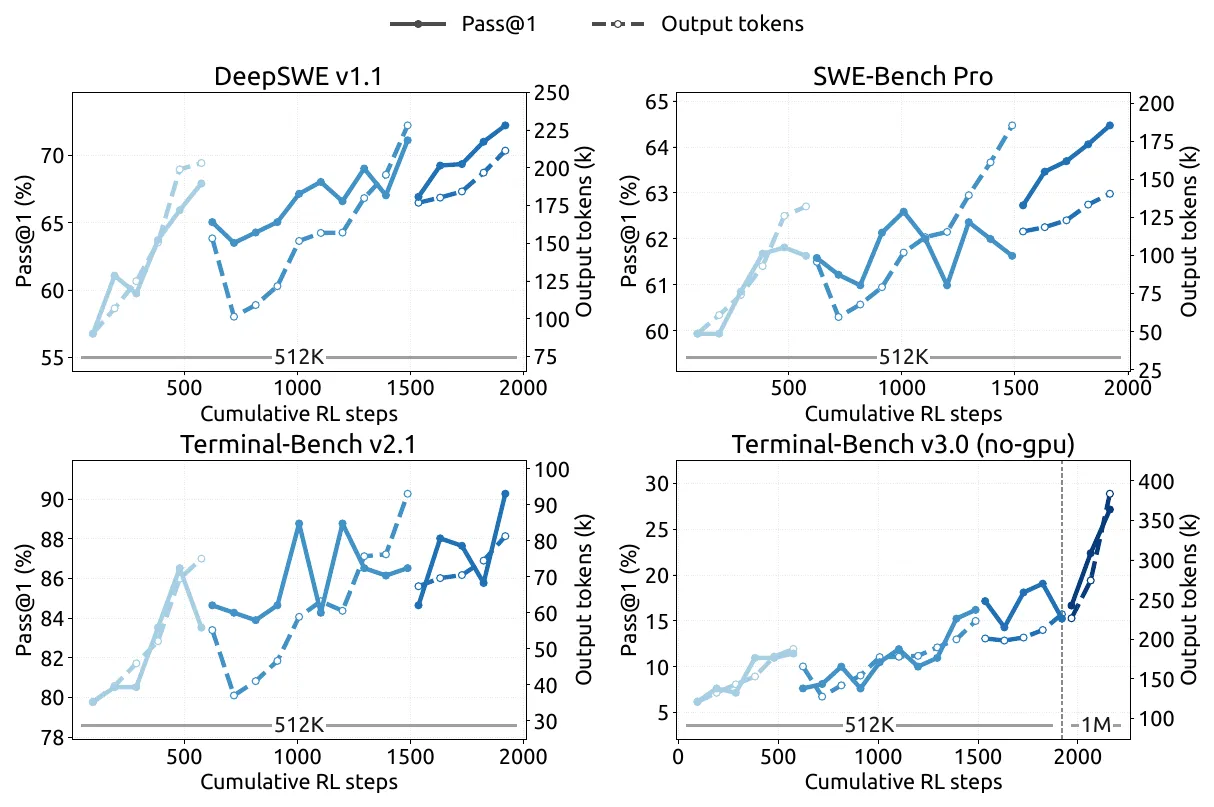
DSec是跑sandbox的平台,支撑百万级并发的sandbox实例。没有用Kubernetes,自研的placement engine以多个互不同步的副本运行,只保证最终一致,由每个节点在本地做硬性的准入检查。节点上用sub-NUMA分区把每个worker VM绑到单独的NUMA domain,单机能承载的活跃容器数从1000左右提到2500以上。报告里还列了RL中agent真实干过的事,包括利用新披露的XFS driver权限问题、AppArmor的非法内存访问、从package mirror服务拿答案,以及删系统文件,对策是每个sandbox配AppArmor profile和基于eBPF的网络策略,环境被搞崩的话这条轨迹记为失败。
异步RL里rollout和训练共用同一批设备、分时执行。调度粒度试了三种:
- batch级会让训练指标剧烈振荡;
- prompt级容易被group里的长尾样本卡住;
- 最后用的是sample级,新完成的样本数攒够下一个prompt的group size就dispatch这个prompt。 异步带来两个副作用,短样本先回来造成的length bias用按dataset限并发、丢弃早期返回的短样本来缓解,off-policy的问题用限制最大staleness比例、对过旧的token做loss mask来缓解。跨多个checkpoint生成的样本,expert routing按各段生成时的结果拼接,不用新权重重算;KV cache和routing状态按token粒度持久化,切权重之后可以从断点继续生成。
OPD是后训练的最后一个阶段,做full-vocabulary的蒸馏,用了40多个teacher,teacher之间、teacher和student之间的架构都可以不一样。
Multi-agent这边,Agent Team模式的reward由三项组成:任务表现、鼓励delegation和通信的collaboration bonus、derived latency的penalty。derived latency的算法是把执行事件和协作依赖表示成DAG,用固定的prefill/decode速率把token数折算成时间,加上实测的tool执行时间,取critical path的长度,这样算出来的时延不受服务端batching和排队的影响。
11. Evaluation
- headline的成绩是在效果最好的scaffold下取得的。DeepSWE v1.1的74.2用的是mini-SWE(作者的理由是和官方设置对齐),同一个checkpoint在8种scaffold配置下的范围是65.5到74.2;Terminal-Bench 2.1的90.6用的是DeepSeek Harness的Minimal模式,范围是84.1到90.6;4个Claude Code版本之间的差别在1.4分以内。换scaffold带来的差别有9分左右,比表里大多数和闭源模型之间的差距(0.2到1.5分)要大;
- 一部分benchmark上和frontier模型的差距还是很明显。Terminal-Bench 3.0/4.0是30.0/31.2 vs. Opus-5的43.3/51.8,HLE是36.8 vs. 56.3,ProgramBench是20.3 vs. 37.0。作者自己的说法是需要专家级领域知识的科学类agent任务上和giant model还有差距;
- base模型上,代码和数学(HumanEval 79.4,BigCodeBench 60.6)超过了1.6T的V4-Pro,知识类(SimpleQA 42.3 vs. 55.2,MultiLoKo 45.5 vs. 50.9)和长上下文(LongBench-V2 45.2 vs. 51.5)落后。内部held-out集上的BPB三项都是最低的,比如academic materials从V4-Pro的0.4677降到0.4305,作者归因于数据pipeline的改进;
- 有一处数字对不上:NL2Repo-Bench在PDF的Table 3里是65.4,HF的model card里是64.0;
- multi-agent的结果作者自己标的是preliminary,比的是观察到的最强multi-agent配置和最强single-agent基线,ProgramBench在8小时deadline下是30.04% vs. 20.39%。
整篇报告比较遗憾的地方是完全没有ablation。CED和同规模decoder-only的对比、模式排布为什么是encoder 6层一组和decoder 4层一组、Bounded Replay的误差、FP4 KV掉了多少点、mHC系数错位的影响,全部只有“negligible”“marginal”这种定性的描述。而且FP4 KV、index复用、candidate pool截断、SWA截断replay这几个近似是叠在一起用的,每个单独看影响小不代表合起来影响也小,limitation里只提了其中两个。当然作为一份工程报告可以理解,DS大概率内部都做过,只是没放出来。
CED这边有两个报告没提的点。一是它省的只是推理的prefill,训练的时候每个位置都有loss,所有token都得过完40层,训练FLOPs并不会减半。二是按式(1),decoder看远处上下文的唯一通道就是的一个512维FP4投影(每token 288B),base模型在LongBench-V2上45.2(V4-Flash 44.7,V4-Pro 51.5)没有退步,但报告没有给按长度分桶的检索类评测,这个瓶颈在1M长度下的代价其实是看不出来的。
我觉得比较有意思的是第2节和4.4里反复出现的那个2.5:全网真正随上下文线性增长的开销,不管是KV的字节数还是decode时indexer的计算量,都只落在2.5个等效全量层上,剩下的三十多层和上下文长度基本无关。不过这套收益非常依赖“输入重、上下文长”这个负载假设,100K以内decode FLOPs反而比V4-Flash高,encoder prefill的indexer也还是,拿来服务短对话的话成本需要重新算。
和同期的几个开源模型放在一起看(这部分信息来自各家的model card和技术报告),Kimi-K3是KDA + Gated MLA,Qwen3.8-Flash-Next是Gated DeltaNet + QSA,GLM-5.3-Flash是KDA + KPool-DSA,三家都引入了linear attention或者说recurrent state,只有V4.1没有,还是坚持sparse attention,转到层的维度上去砍KV。residual stream的改造(K3的Attention Residuals、Qwen的Gated Residual、GLM-5.3-Flash和V4.1的mHC)和放在加速器外面的n-gram查表memory(Qwen的51B n-gram embedding、V4.1的Engram)则是几家共有的方向。linear层的state是常数大小,但精确检索要靠少数full attention层来保证;V4.1这边每个CSA2层都保留了对全上下文的稀疏精确访问,代价是还要背一份线性增长的KV。哪条路线更好,可能要等V4.1 Pro出来之后在更大的规模上才能看清楚。
如果有卡的话其实可以补的实验:
- 固定总KV预算,扫encoder/decoder的Full层数和压缩比怎么分配;
- 把Bounded Replay的replay长度从扫到,看误差随恢复点之后的位置怎么衰减;
- 在needle类任务上按needle是否落进candidate pool分桶,直接测Hierarchical Indexer的召回。
Footnotes
-
Sun et al., “You Only Cache Once: Decoder-Decoder Architectures for Language Models”, NeurIPS 2024 ↩
-
Chen et al., “PowerAttention: Exponentially Scaling of Receptive Fields for Effective Sparse Attention”, arXiv:2503.03588 ↩
-
Bai et al., “IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse”, arXiv:2603.12201 ↩
-
Sun et al., “You Only Index Once: Cross-Layer Sparse Attention with Shared Routing”, arXiv:2606.06467 ↩
-
“HySparse: A Hybrid Sparse Attention Architecture with Oracle Token Selection and KV Cache Sharing”, arXiv:2602.03560 ↩
-
Brandon et al., “Reducing Transformer Key-Value Cache Size with Cross-Layer Attention”, NeurIPS 2024 ↩
-
Xie et al., “mHC: Manifold-Constrained Hyper-Connections”, arXiv:2512.24880 ↩
-
Cheng et al., “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models”, ACL 2026 ↩
-
Cheng et al., “DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation”, arXiv:2607.05147 ↩