原文:arXiv:2511.05215 · Manjunath et al., 2025
摘要: 稀疏 DNN 加速器要么专做 ANN 执行、要么专做 SNN 执行,当负载特征在一层之内发生变化时,就会在能耗或延迟上留下浪费。在 layer 或 tile 粒度上切换模式的混合加速器,则受困于 PE 利用率低,因为一种 core 工作时另一种只能空闲。NeuroFlex 是第一个能在零精度损失下、把每个输出元素独立分配到 ANN 或 SNN 执行模式的加速器。我们把 integer-exact 的 ANN-SNN 等价性从 layer 扩展到单个输出元素,从而使模式切换不引入任何转换误差。一个离线的 cost-guided scheduler 按每个元素的边际 energy-delay 权衡给它打分,并把任务打包分配到各个 PE 上,PE 利用率达到 97-99%,而 layer-wise 的混合方案只有 40-45%。相比一个强 ANN-only baseline,NeuroFlex 把 EDP 降低了 57-67%;相比 dual-sparse 的 SNN-only baseline,最高加速 2.5×。在视觉、语言和 transformer 负载上,我们的 cost-guided scheduler 相比随机的元素分配,把吞吐提升了 16-19%。
1. Intro
稀疏加速器中,dual sparsity(weight 和 activation 两侧都跳零,只算两边都非零的 operand 对)已经做了很多,代表是 SparTen、Gamma 这一批。SNN 侧也有 LoAS 这样的 dual-sparse 加速器。作者的出发点是两边各有短板:ANN 的 MAC 快但功耗高;SNN 的 AC 省能量,但一个 activation 要在 个 timestep 上串行累加出来,延迟随 增长。
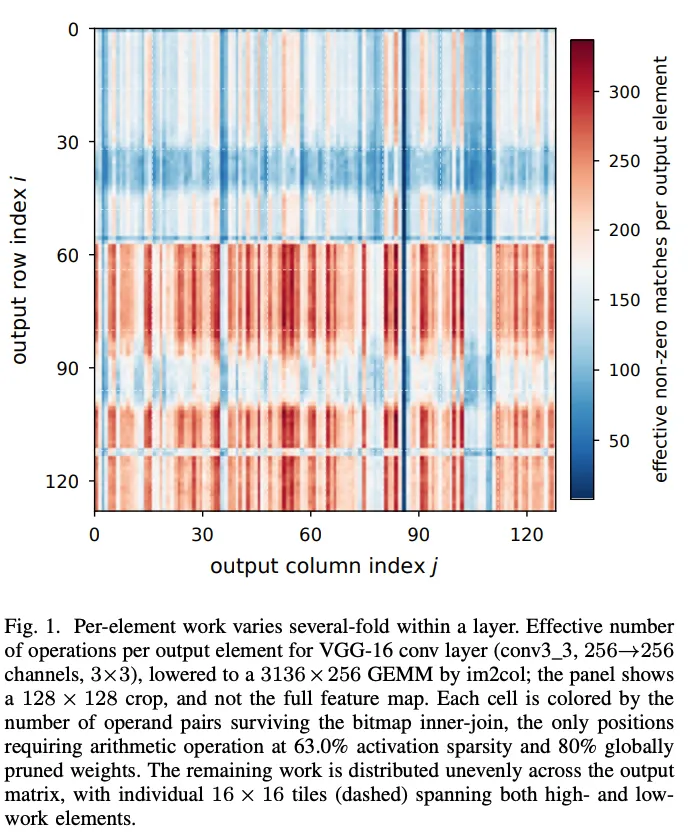 文章最主要的观察是 Fig.1。VGG-16 的 conv3_3 经过 im2col 变成 的 GEMM。在 63% 的 activation 稀疏度和 80% 的全局 weight 剪枝下,作者统计了每个输出元素 在 bitmap inner-join 之后剩下的有效 operand 对数(后面记作 )。这个数在层内能差好几倍,沿空间和 channel 两个方向都有结构,一个 的 tile 里同时有工作量大和小的元素。
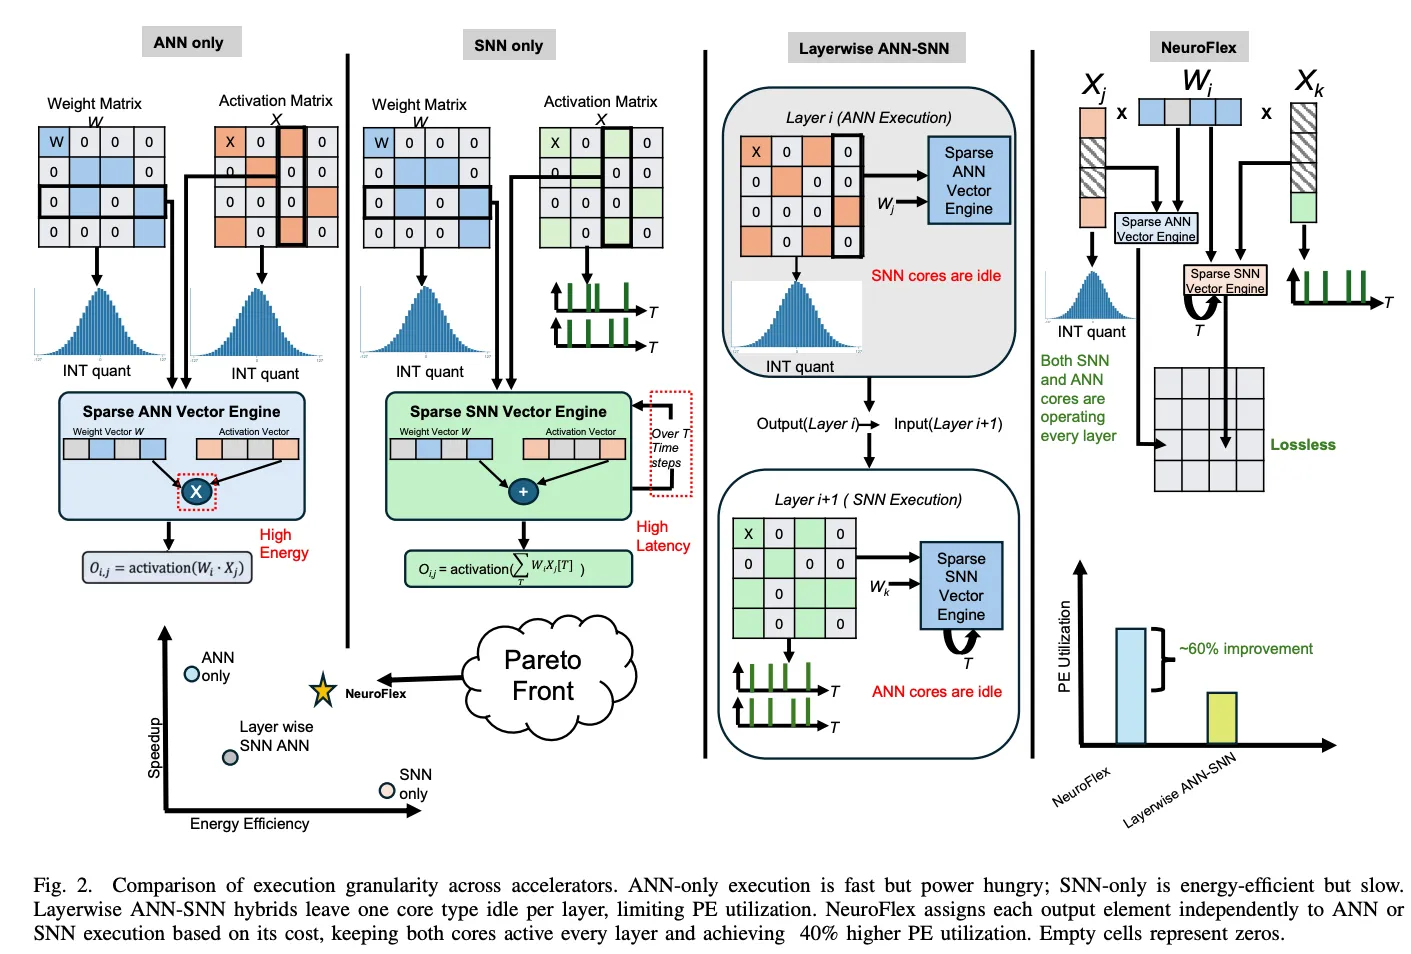
作者据此认为 match 多的元素适合 ANN,match 少的适合 SNN。现有的混合加速器只能按 layer(NEBULA、EPHA)或者按 tile(C-DNN、C-Transformer)选模式。layer level 切换时总有一种 core 闲着,tile 内部的差异也利用不到。C-DNN 用的转换还是有损的,送去 SNN 的部分要掉精度。
之前没人做到 elementwise,作者给的理由是 ANN-SNN 转换一直是近似的,layer 级还能靠大量神经元把误差平均掉,单个元素没有这个余地。同组去年的 PASCA 证明了 QCFS 激活的 ANN 和转换后的 SNN 在整数运算下严格等价。证明只依赖每个输出元素自己的局部整数运算,所以等价性对单个元素也成立,层内混用两种模式不会掉精度。
Contribution:
- 把 PASCAL 的 integer-exact 等价性扩展到单个输出元素;
- 离线的 cost-guided scheduler,用模拟退火给每个元素选 core,最小化 EDP;
- NeuroFlex 架构,ANN/SNN 两种 core 共享存储层级,在元素粒度上同时执行;
- 在 CNN、Transformer、LLM 上的评估。
2. Related Work
2.1. ANN-SNN Conversion
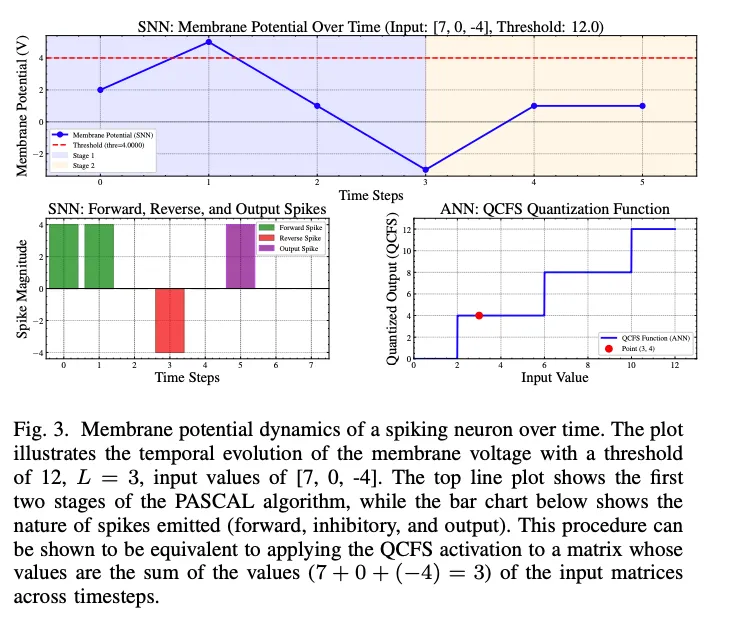 QCFS 激活:
是量化级数, 是可训练的阈值。PASCAL 的神经元分三个阶段,阈值 ,初始膜电位 :
2.2. Sparsity Exploitation in DNN Accelerators
SparTen 是 bitmap inner-join,每个元素 1 bit metadata。Gamma 是 Gustavson + CSR 类编码,metadata 是多字节的,访存更重。LoAS 用 FTP dataflow 把所有 timestep 并行掉,但 laggy prefix-sum 每个 chunk 要 8 个周期,还需要 correction accumulator 对齐快慢两路 prefix。这几个都是单模式的。
2.3. Hybrid ANN-SNN Algorithms and Hardware Architectures
算法侧有 slow-fast(低频 ANN 给 SNN 初始化膜电位)和 layer-wise 交替的混合模型。硬件侧 NEBULA 和 EPHA 是 layer 级切换,没利用稀疏。C-DNN 是 tile 级,转换有损,也没做 dual sparsity。
3. Lossless ANN-SNN Conversion and Dataflow
3.1. Element-level Extension of PASCAL Equivalence
两个 Corollary 给的是 INT8 下要满足的条件。输入层要求 是整数,且 在 INT8 范围内。MatMul + BN 的层要求 、、 和 都是 INT8 范围内的整数。Theorem 1 说对任意输出元素 ,SNN 实现和 ANN 实现等价。证明只有一个 sketch:integrate、threshold、reset 只涉及该元素自己的输入和权重,和其他输出元素无关,所以 PASCAL 的 Thm 3.3–3.6 可以逐元素套用。
这个定理基本是显然的,IF 神经元的动力学本来就是每个神经元各管各的。真正让层内混用成立的是下一节的设计:层与层之间传的永远是整数,脉冲只存在于 PE 内部。
3.2. Unified INT8 Dataflow and On-the-Fly Mode Switching
 所有 activation 和 weight 都以 INT8 存储,数据本身不带任何模式信息。模式是调度的属性,由离线 scheduler 给出的 per-element binary mask 决定。
- ANN 模式:PE 对 match 上的非零对做 MAC,过 QCFS,写回 INT8。
- SNN 模式:PE 用组合逻辑把 match 上的非零 INT8 activation 展开成二值脉冲串,累加带权脉冲并比较阈值,再处理残余膜电位。 时是 步串行迭代,最后同样写回 INT8。
- 两种模式走同一套 inner-product dataflow 和 FiberCache 访问模式,所以混合执行不增加访存。
这个设计本身挺干净的。不过这样一来,SNN 模式和一般说的 SNN 已经没什么关系了:没有跨层传递的脉冲,没有事件驱动,时间维度在 PE 内部产生,又在 PE 内部消掉。
、 的配置下,activation 的取值是 。SNN core 做的事情是:
- 把数值 展开成 8 个 slot 的 unary 编码(按 Phase 3 的发放方式,应该是前 个 slot 为 1);
- 对每个 match 做至多 8 次条件加法;
- 最后用 23 步膜电位迭代算出一个 clamp。
ANN core 里,同一个 clamp 是两个比较器加一个 mux(4.3)。两种 core 算的是同一个 QANN,区别只在乘法是用乘法器做,还是用 unary 的 bit-serial 累加做。
从这个角度看,AC 替代 MAC 的收益要打折扣。ANN core 的 “INT8 MAC” 实际乘的是一个 8-bit weight 和一个不超过 8 的数,有效位宽不到 4 bit。unary 编码下数值 要 次加法,普通的二进制 shift-add 只要 次, 时最多 3 次。按 Horowitz 45nm 的数,8-bit 乘法 0.2 pJ,8-bit 加法 0.03 pJ,一个 的乘法器量级上相当于三次多的加法, 取 3 左右的时候两边就打平了。如果 ANN PE 用的是完整的 乘法器,对 ANN 侧是不太公平的。
4. NeuroFlex Architecture
4.1. Overview & Core Organization
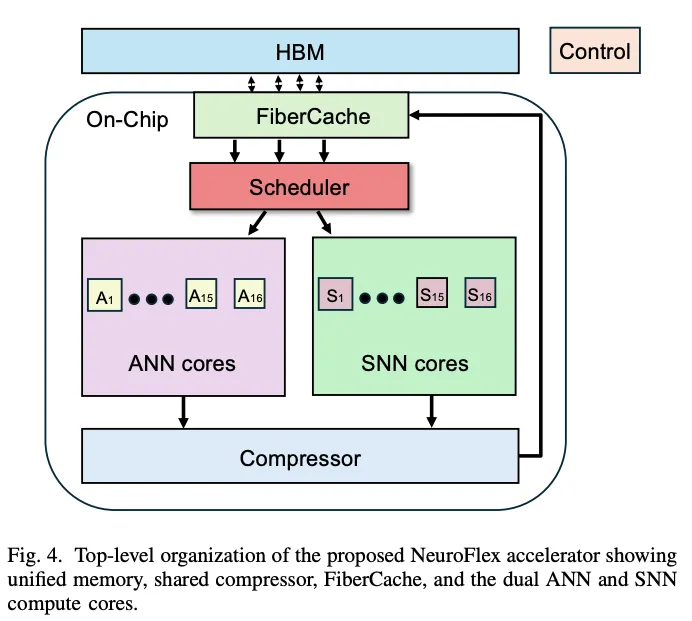
两种 core 各是一组 PE,共享 HBM 后面的 FiberCache。输出统一经过一个 compressor 再写回片上 SRAM。中心 scheduler 分发任务,core 内空闲的 PE 贪心地填。
4.2. Processing-Element Microarchitecture
每个 PE 收到的是一个 chunk(128-bit bitmap + 打包好的非零值),每周期处理一个非零元素,chunk 之间插一个 bubble。
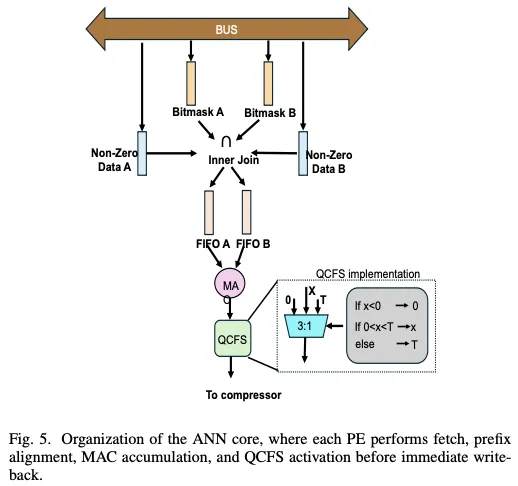 ANN PE 来自 SparTen:
- fast prefix 一个周期内给出读偏移;
- 地址生成器对齐 activation 和 weight 流;
- MAC 阵列累加,然后过 QCFS;
- 、 时 QCFS 退化成 上的饱和 clamp。
SNN PE 是三级流水。前端有两套 prefix-sum:fast prefix 单周期给出对齐用的早期偏移;laggy prefix(16 个加法器 + 128-bit buffer)用 8 个周期算完有效 match。只有 match 上的 activation 才往后送。三个 stage:
- Stage 1 Spike Generation:纯组合逻辑,INT8 → 8-bit 脉冲串,只对 inner-join 之后留下的对生成;
- Stage 2 Spike Count:硬件上展开 步,每步把脉冲 × weight 加到膜电位寄存器,和 比较,超过就记一个脉冲并 soft reset。带权输入 11-bit signed,膜电位 14-bit signed,计数器 4-bit unsigned;
- Stage 3 Membrane Potential Reinitialization:最多 8 步,没有新输入。膜电位 就补一个正脉冲并减 ,为负就发一个负脉冲并加 。计数器变成 5-bit signed,结果送 compressor。22
4.3. Memory Hierarchy and Interconnect
FiberCache 每个 cache line 存一个 bitmap 和一个 continuation pointer。它分了很多 bank 支持 PE 并发访问,替换策略按 reuse。swizzle-switch crossbar 每次传 128-bit 的 bitmap + data chunk,用 single-credit 反压。scheduler 通过统一的命令队列,给每个元素下发 mode token 和 PE 分配。
5. Cost Function and Scheduling
对 core ,元素 的能耗和延迟是 match 数的线性函数:
是 RTL microbenchmark 测出来的 per-match 系数, 是每个元素的固定开销。 取 128 个校准样本上 match 数的 P90,用来防 makespan 的尾延迟。
是分配矩阵。能耗对元素可加。延迟是两种 core 各自 PE 上 makespan 的最大值 。目标是 。因为 makespan 的耦合,这是 NP-hard 的。求解用模拟退火:
- 每次翻转一个元素, 重算 makespan,几何降温;
- 初始解是每个元素去边际代价低的 core;
- 每层迭代 次, 的输出在 EPYC 9555 上不到 2 秒;
- mask 和权重存在一起,推理时没有运行时开销。
这里有两个地方我没太想明白。
第一,在这个线性模型下,“哪些元素去 SNN” 其实没有看上去那么重要。
- 记送去 SNN 的元素的总 match 数为 、元素个数为 ,则 。
- 元素数量(几十万)远大于 PE 数量(16),packing 基本能做到完全均衡,。所以 EDP 只依赖 两个聚合量。
- 给定 ,是拿很多小元素去凑,还是拿少数大元素去凑,只改变 ,也就是只通过固定项 起作用。
- SNN 侧每个元素固定要走 23 步迭代,laggy prefix 每个 chunk 还要 8 个周期,直觉上 都比 ANN 侧大。那应该是让 尽量小、把 match 多的元素送去 SNN 才对,和 Intro 的说法是反的。Intro 对 “match 少的去 SNN” 的解释,是这些元素需要摊薄 timestep 开销的操作更少。但操作少的时候,固定开销只会更难摊薄。
- 文章没给四组系数的数值,也没画 scheduler 最后给出的 mask,没法判断实际的分配是什么样的。
第二,mask 是离线定死的,但 activation 的稀疏 pattern 随输入变。
6. Experimental Methodology
setup:
- 16 SNN PE + 16 ANN PE,8-bit weight,32 个 inner-join unit;
- 512 KB global cache(32 bank,32-way),两个 swizzle-switch crossbar,HBM 128 GB/s;
- ;
- 模型:VGG-16、ResNet-34、GoogleNet、BERT、ViT-S、GPT-2 XL、OPT-6.7B,先用 QCFS 训练,再转 PASCAL SNN;
- 硬件 baseline:SparTen(ANN-only)和 LoAS(SNN-only),都配成 32 PE + 同样的 cache 和 HBM,activation 分别换成 QCFS 和 PASCAL;
- 粒度 baseline:LayerWise / TileWise / ElementWise,都跑在同一份 NeuroFlex 硬件上,用同一个 cost function;
- 关键模块写了 RTL,DC 综合,40nm,560 MHz。存储用 CACTI 7.0。整体性能来自 Python 写的 cycle-level simulator。没有报 area 和绝对功耗。
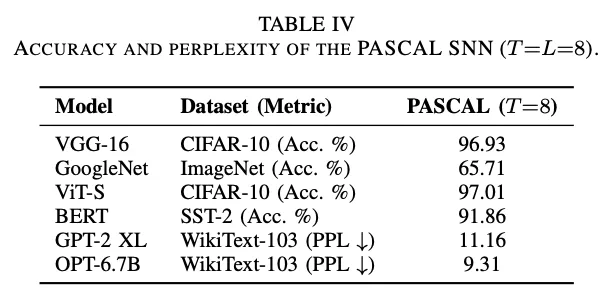 表里只有 PASCAL SNN 一列,没有原始 FP 模型的精度。lossless 指的是 SNN 相对 QCFS-ANN 无损,QCFS-ANN 相对原模型掉了多少是另一回事。比如 GoogleNet 的 65.71%,印象里 torchvision 的 FP 版本在 69.8% 左右。
LLM 的部分基本没有交代:
- Corollary 只覆盖了 MatMul + BN,LayerNorm、softmax、GELU 怎么处理没说;
- attention 里 activation 乘 activation 的 matmul 走不走加速器,没说;
- 9 级 activation 的 GPT-2 XL 和 OPT-6.7B 是怎么训到这个 PPL 的,也没说。
7. Experimental Results
7.1. End-to-End Performance & EDP
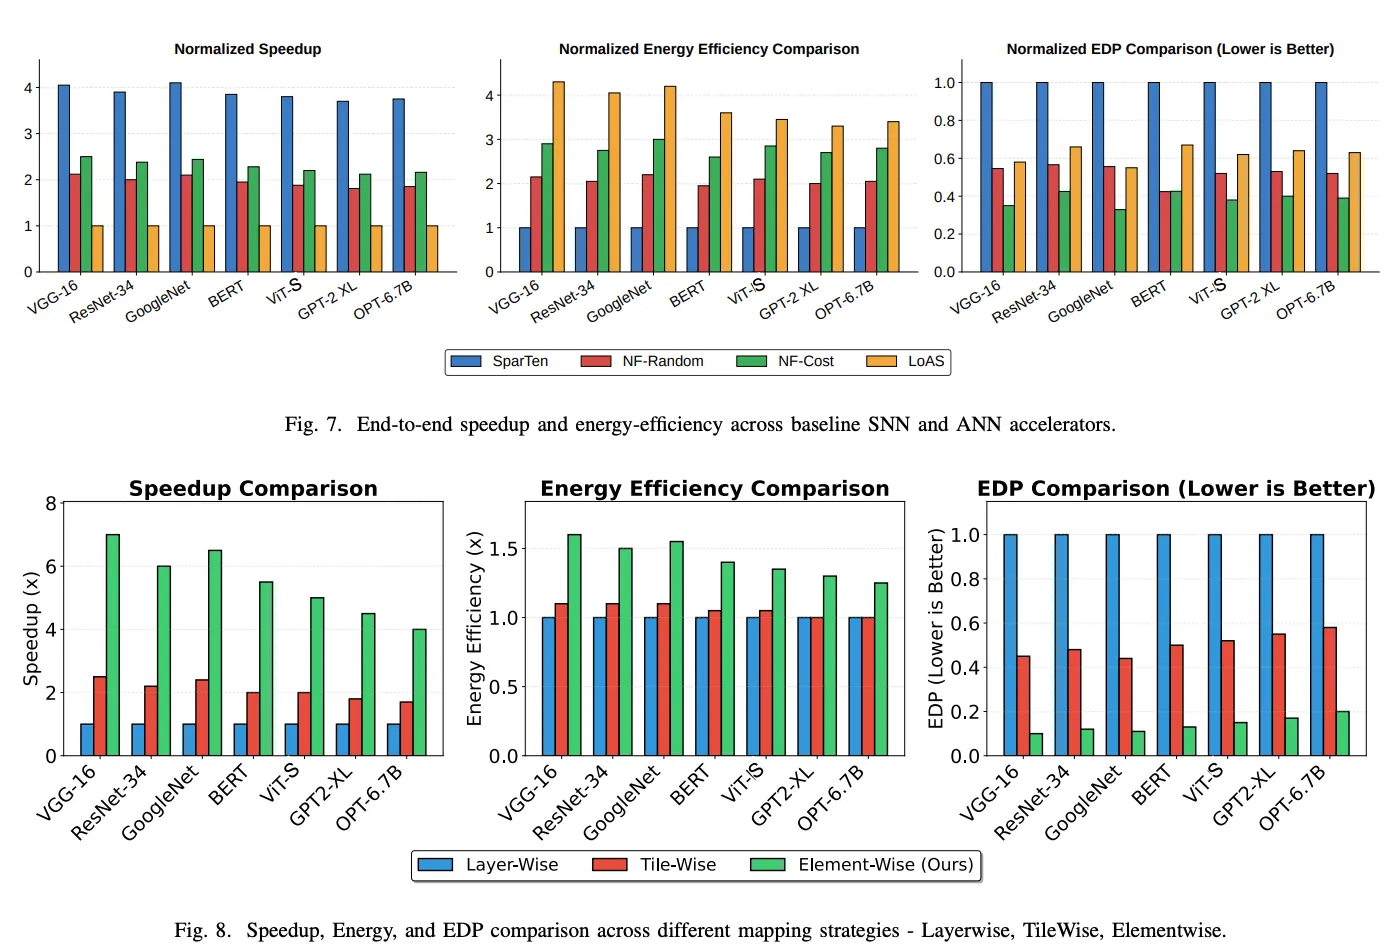 SparTen 仍然是最快的。LoAS 能耗最低,但 EDP 比 NeuroFlex 高 57.1-69.5%。NeuroFlex 相比 LoAS 最高加速 2.5×。
能耗口径。 文章里有一句话:三个设计共享 bitmap 编码、FiberCache 和存储层级,所以 memory subsystem 在归一化比较里 “cancels out”。一个相同的加项,在比值里是消不掉的。所以我的理解是,Fig.7/8 的能耗只算了计算侧。7.2 和 Gamma、Prosperity 比的时候,专门强调了 end-to-end、计入访存能耗,也印证了这一点。
而 Fig.12 里 global cache 占系统功耗的 63.9%。粗算一下 VGG-16:
- 计算侧 EDP 是 SparTen 的 0.35。假设延迟持平(文章说 SparTen 还是最快的,所以这是偏乐观的假设),计算能耗就是 0.35。
- 按 Fig.12 的比例,访存能耗是计算能耗的 倍,也就是 0.62,两边相同。
- 系统级的能耗比是 ,EDP 降幅从 65% 变成 40% 左右。
- 如果 NeuroFlex 比 SparTen 慢 20%,就只剩 36%。
- Fig.12 是哪个模型的 breakdown,文章没说,这里当成 VGG-16 用了。
几个 headline 数字放在一起对不上。 先只看 per-match 的线性部分。
- 把 32 个 ANN PE 的 SparTen 记为 。
- 把 32 个 SNN PE 的 LoAS 记为 。 是 SNN PE 相对 ANN PE 的减速。
- NeuroFlex 是 16+16,设分到两侧的工作量占比为 ()。
则
记 ,也就是两个单模式 baseline 里较好的那个 EDP。由 ,上式三项的系数,分别不小于 的对应系数,所以 。
也就是说,线性代价下,16+16 的混合在 EDP 上赢不了 32 个 ANN PE 和 32 个 SNN PE 里较好的那一个。而文章报告的是两个都被明显超过:比 SparTen 低 57-67%,LoAS 又比 NeuroFlex 高 57-70%。另外 2.5× 的加速在均衡分配下对应 ,此时 NeuroFlex 应该比 SparTen 慢 60%。
所以收益只能来自线性部分之外,有两种可能:
- 固定项很大,而且两种 core 的优劣随元素交叉:小元素在 SNN 上又快又省,大元素在 ANN 上更快。这和 SNN PE 的结构不太相符。
- baseline 和 NeuroFlex 之间,差的不只是 core 的种类。
我比较怀疑后者。NeuroFlex 的元素是离线按 打包到各个 PE 上的,利用率 97-99%。SparTen 和 LoAS 如果用的是各自原本的调度,层内 差好几倍带来的空转,就会同时算进它们的延迟和能耗里。
random 分配具体怎么做的,文章没细说,但它已经能拿到 43-58% 的 EDP 降幅。BERT 上 random 的 57.6% 和 cost-guided 的 57.4% 基本没有区别。吞吐高 16.7% 而 EDP 持平,等于能耗也高了 17% 左右。这说明大部分收益和 ”给元素选对模式” 关系不大。
7.2. Comparison with Gamma and Prosperity
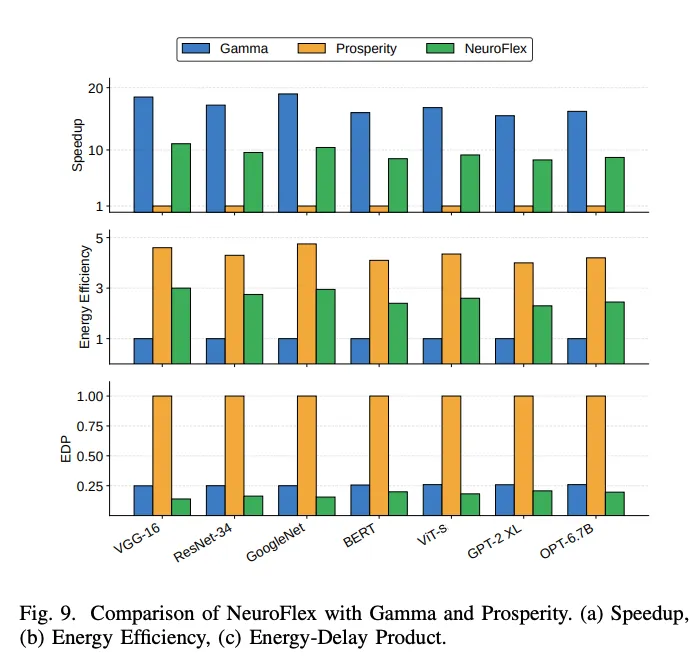 end-to-end 口径(含访存):
- Gamma 速度最高(约 19×),但 CSR metadata 的访存让能效停在 baseline;
- NeuroFlex 在 VGG-16 上比 Prosperity 快约 12×,能效高 2.3-3.0×;
- EDP 比 Prosperity 低 5-6×,比 Gamma 低 1.5-2×。
文章把 Prosperity 的 product sparsity 描述成 ”输出元素的点积为零时整体跳过”,这个不对。Prosperity 做的是在脉冲矩阵的行之间找相同的二值子组合,复用已经算过的内积(之前读过),和跳零是两回事。Prosperity 跑的是真正的多 timestep 脉冲输入,在这个理解下的 12× 是怎么比出来的,我不太确定。
7.3. Scheduling Granularity & PE Utilization
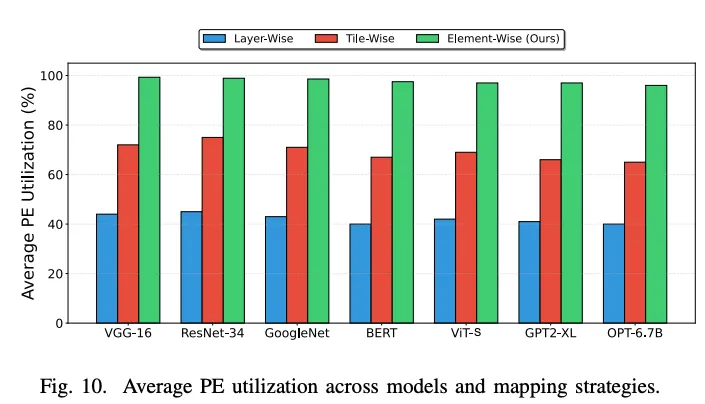 Element-wise 的利用率:VGG-16 99.3%,ResNet-34 98.9%,GoogleNet 98.6%,BERT 97.5%。Tile-wise 在 60-84% 之间。
LayerWise 是跑在 16+16 的 NeuroFlex 硬件上的。一层只用一种模式的话,另外 16 个 PE 必然空闲,利用率上限就是 50%。40-45% 这个数,更多是 baseline 的构造方式决定的。按 Related Work 自己的描述,EPHA 的 PE 可以配置成 ANN 或 SNN 模式,真正的 layer 级混合加速器不会有一半硬件闲着。
这几个数字在文中也不太一致:
- layer-wise 在摘要里是 40-45%,粒度 ablation 那节又写 60-76%;
- 利用率那节给的是 tile-wise 的数,解释用的却是 layer 级切换时另一种 core 空闲的说法。
利用率本身也不是目标。SNN PE 花 23 步迭代算一个 clamp 的时候,同样算 busy。
7.4. Scalability
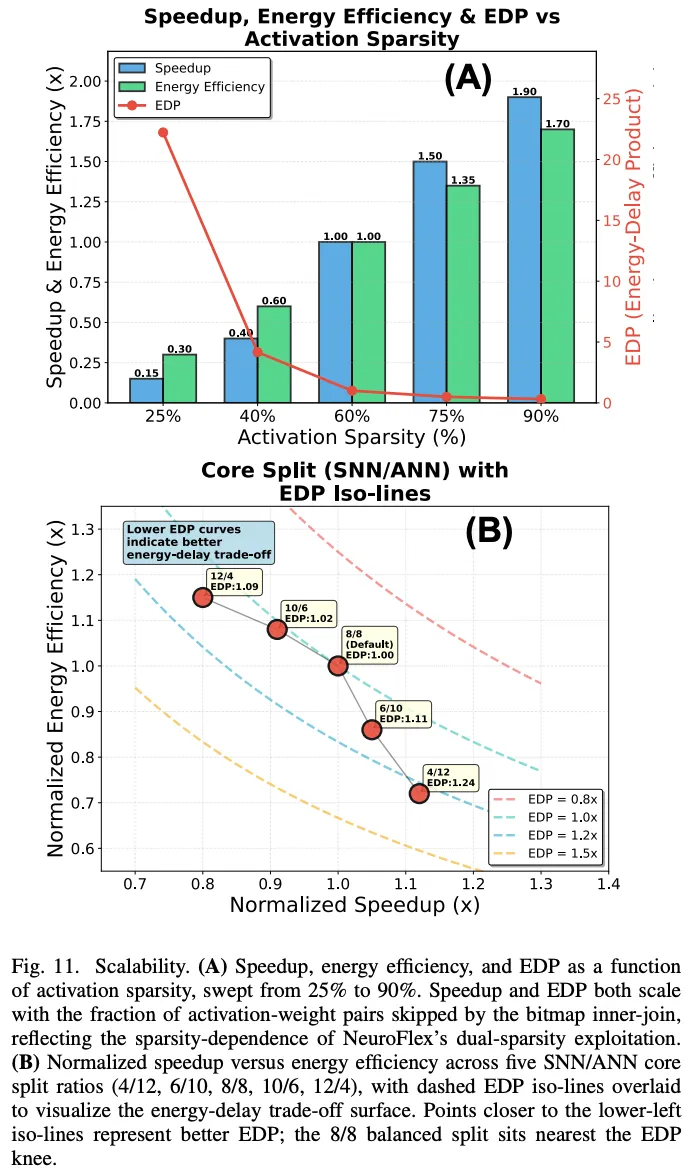
- activation 稀疏度从 90% 降到 60%、25%,相对加速从 100% 掉到 21.3%、12.5%。收益基本正比于 inner-join 跳掉的比例。
- core 配比:SNN/ANN = 6/10 时速度 1.12×、能效降到 86%;10/6 时能效 1.15×、速度 91%;8/8 在 EDP 的拐点附近。
7.5. Power Analysis
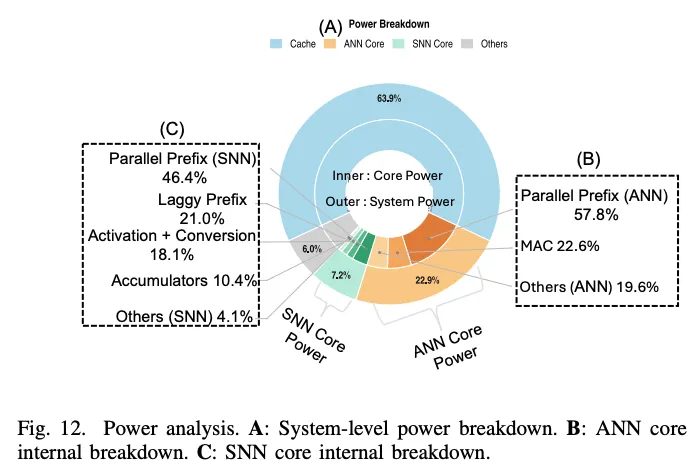 QCFS 比 ReLU 贵(ReLU 是 QCFS 的 0.8×),PASCAL 神经元比 LIF 贵(LIF 是 PASCAL 的 0.4×),但两种激活单元加起来不到系统功耗的 1%。作者自己的结论是,后续优化应该放在存储层级上。
MAC 占系统功耗的比例是 ,AC 换 MAC 这件事能碰到的也就是这几个点。
另外同样是 16 个 PE,SNN core 的功耗只有 ANN core 的 1/4,而 MAC 只占 ANN core 的 23%。这个 4× 显然不全是 AC 带来的。我的理解是,SNN PE 每个 chunk 要等 8 个周期的 laggy prefix,单位时间里翻转少,功耗自然低。换算成每个 match 的能耗,差距没有这么大。
8. Conclusion
作者自己写的局限是方法只对 activation 能用 QCFS 表示的模型成立。
感觉的优点:
- Fig.1 这种逐元素的有效 match 数分析,对任何 dual-sparse 的设计都是有用的 profiling。
- 模式属于调度、层间统一存 INT8 的做法,也干净。
- Fig.12 是一个不错的数据点:在一个认真做了访存建模的稀疏加速器里,cache 占 64%,MAC 不到 7%。这和社区里只数 AC/MAC 次数的 energy model 给人的印象差很多,之后讨论 SNN 和 QANN 的能耗对比的时候可以拿来用。
缺点:
- 主实验的能耗口径;
- 几个 headline 数字之间的关系;
- scheduler 到底学到了什么。 这几个都没法从文章里得到回答。另外,这里的 SNN 是一个关在 PE 内部的 unary 计算。层间接口一旦是整数,SNN 和 QANN 的 bit-serial 实现之间就没有界线了。我们更关心:
- 跨层的事件驱动;
- 时间上的稀疏,比如 DiffEncode 之后帧间的增量。 就做不出来? 反过来,它可以当成一个参照:不利用时间维度的时候,“SNN 模式” 在一个做了 dual sparsity 的加速器里,大概就值这么多。
脚注
-
用负脉冲修正 overfiring,从而让 QANN 和 SNN 严格等价,这个思路在 SpikeZIP-TF 的 ST-BIF 里就有了,本文的 related work 里没有提。区别是 ST-BIF 边收边发、随时修正,PASCAL 是等 步输入全部收完,再统一修正、统一输出,每一层天然要多等 步。 ↩
-
硬件的三个 stage 和 PASCAL 的三个 phase 对应得不太清楚。算法里带输入的累加是 步,Stage 2 写的却是展开 步,而脉冲串有 8 个 slot。第 8 个 slot 的输入在哪里加进去的,没看明白。 ↩
-
文章里 element 和 column 两个词是混用的。Related Work 里写 column granularity 是 inner-product dataflow 能独立分配的最细粒度,Algorithm 1 的标题也还是 Column-Wise。估计早期版本是按输出列调度的。列的工作量主要由 weight 决定,离线调度在那个粒度上反而更说得通。 ↩
-
Fig.1 的 conv3_3 是 ,对应 的 feature map,也就是 224 分辨率的输入。但 Table IV 里 VGG-16 是在 CIFAR-10 上测的。 ↩
-
一些小问题:core 配比那节的 SNN/ANN = 10/8 应该是 10/6。EDP 那节引的 Figure 7 应该是 Figure 8。和 Gamma 比的那节里,Gamma 引成了 [8](Spada)。Fig.12B 三项加起来是 102%,12C 加起来是 95.7%。 ↩